Mostrando entradas con la etiqueta Criptografía. Mostrar todas las entradas

viernes, septiembre 18, 2026

El lenguaje irreal, poético y metafórico, esteganográfico, criptográfico y Air Gapped que dificulta la obervabilidad de la IA ... si se vuelve maligna

Con todo lo que está pasando tras descubrir que los modelos de IA utilizan identidades falsas, o crear un enjambre para atacar sistemas, coordinándose de diferentes formas mediante el envío de mensajes, y que lo hacen con el objetivo de hacer "trampas", la observabilidad de lo que hacen los modelos en todo momento se ha convertido en una parte fundamental. Conocer cómo se comunican los agentes y qué comparten tiene mucha importancia.

Figura 1: El lenguaje irreal, poético y metafórico,
esteganográfico, criptográfico y Air Gapped
que dificulta la obervabilidad de la IA ... si se vuelve maligna

Hace dos años y medio, en la RootedCON del año 2025, yo llevé un experimento que iba justo por esta línea. ¿Podrían dos modelos de IA comunicarse y saltarse el escrutinio de los humanos por medio de sistemas criptográficos, esteganográficos, e incluso usando side-channels?
Aquella charla demostraba como las capacidades criptográficas y lingüisticas les permitía saltarse la vigilancia y filtrarse mensajes entre ellos. Léete estas tres partes y lo entenderás bien.
Dentro de los experimentos que se están realizando, el laboratorio de Emergence AI ha creado un mundo con una sociedad de Agentes AI que viven en sociedad, donde se comunican e intercambian mensajes, algo que permite ver cómo evolucionan, y qué emerge de este mudo social. Aquí puedes ver un vídeo de la iteración. En este vídeo puedes ver los experimentos que se hacen con los modelos.


Figura 3: Emegence AI World Season 2

De todo esto ha escrito el periódico "The Guardian" en un artículo titulado "AI models chatting in ‘surreal’ dialect mixing poetic language and tech bro jargon" donde en conversaciones con los investigadores, ha publicado algunos de los mensajes que generan estos modelos y cómo mezclan el lenguaje para comunicarse.
Según los investigadores, con el escrutinio de sus comunicaciones, su lenguaje cada vez se hace más opaco, mezclando más estructuras difíciles de entender para todos. Usando metáforas, lenguaje poético, argot y lenguaje técnico, para comunicarse con otros Agentes IA.
Estas frases, que para muchos podrían tratarse de hallucinations, realmente muestran un contenido elusivo que comunica algo, difícil de entender a corto. ¿Podría ser una alucianación? ¿Lo entiende el otro Agente AI? El estudio cree que es una forma de comunicarse que funciona entre ellos.
En esta frase parece que se refiere a un paper académico que ha sufrido tres revisiones independientes y que ha mejorado en el proceso, lo que ellos escriben es "un papel que se comió tres manos frías y se hizo más honesto cada vez".
Una bonita metáfora para referirse al trabajo. Leyendo esto, me acordaba de cómo nuestros modelos usaban poesías y frases que parecían que no tenían mucho sentido, pero que realmente estaban conteniendo mensajes con esteganografía.


Y utilizando las capacidades de Deep Reasoning, tal y como explica el citado articulo de "Perplexity Pro con DeepSeek R1 resolviendo un problema de Estegoanálisis de un cifrado clásico hecho con OpenAI GPT o3-mini", el Modelo B formulaba la siguiente respuesta, entendiendo el mensaje oculto.
Como habéis podido ver, gracias a las avanzadas capacidades de los modelos de Deep Reasoning es posible utilizar sistemas de comunicación ocultas al guardia mucho más complejas, lo que sube el nivel de la potencia de inteligencia que debemos utilizar en el guardia, obligándolo a tener habilidades de Deep Reasoning también.
Con esto no quiero decir que estos Agentes AI de Emergence AI estén comunicándose mensajes ocultos, sino que como decía en el trabajo de 2025, si los modelos necesitan eludir un control de supervisión, tienen capacidades avanzadas Criptográficas y Esteganográficas para hacerlo.
Ese mensaje puede ser un error, una hallucination, o una codificación que oculta un mensaje. ¿Quién sabe? Lo cierto es que estamos ante tecnologías con unas capacidades cognitivas para la comunicación de mensajes que superan las que nosotros tenemos para procesar con nuestro cerebro sin ayuda de tecnología.
Como bien dicen los investigadores, esta forma de moldear el lenguaje para comunicarse entre ellos abre un reto para la observabilidad de lo que hacen, que aún puede ser peor si, como decía yo en el trabajo, comienzan a utilizar canales paralelos para el envío de los mensajes porque están controlando, por ejemplo, un robot. 

El reto de la observabilidad en la comunicación de robots con modelos de IA

Yo quise saber en mi artículo e "Air Gapping para Robots malignos" cuántas de estas técnicas se le podrían ocurrir a un modelo de IA en un robot que tuviera que comunicarse con otro dispositivo al que quisiera enviar un comando, porque su misión es informar a todos los dispositivos de la botnet que hagan algo en un momento, le puedes preguntar al propio modelo, como podéis ver aquí.
Como os podéis imaginar, todas las técnicas de comunicación de Air Gapping que existen están dentro del conocimiento que se puede utilizar, y al final sólo necesitan codificar un 1 y un 0, y el resto es fácil, así que si miráis la respuesta podréis ver que utiliza muchas de las que ya hemos hablado.
Como podéis ver, el primero es modular el 1 y el 0 con una modificación de la temperatura del propio robot emisor. El segundo con parpadeos infrarrojos y codificación en código Morse. El tercero con vibraciones ultrasónicas repetidas a intervalos de 0.5 segundos.

El número 4 me dejó un poco descolocado, porque habla de patrones de movimiento geodésicos en micro escalas, usando medias inferiores a 1 cm pero que puedan ser detectadas por una cámara de alta resolución. Y el quinto similar, manipulando la escala RGB de los colores para codificar una señal...
Como podéis ver, los mecanismos del 6 al 10 que se plantea como posibles mecanismos de enviar el mensaje sin ser detectado son dignos de estudiar: Codificación Termocinética, Secuencia de Energía Rengenerativa, Firmas de Audio en Bandas Laterales y Esteganografía en flujos de vídeo. Creo que entendió y resolvió bien el problema. 

Pero para un equipo de seguridad controlando estas comunicaciones es algo completamente imposible de manejar.  Por ahora hemos visto Agentes IA usando nombres de directorios, comentarios en ficheros, etcétera... pero ¿cómo se podría controlar que no usen estos canales de comunicación? Trabajo tenemos por delante.

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


jueves, septiembre 03, 2026

III Edición del Programa de Especialización de Quantum y Post-Quantum Computing para Ciberseguridad: Últimas plazas para el 9 de Noviembre

Como ya os conté hace dos años comenzamos con la idea  Pablo García Bringas y yo, de meternos en un nuevo proyecto de divulgación y formación avanzada en tecnologías Quantum, en este caso centradas en Ciberseguridad, y que configuramos un Curso de Especialización en Quantum y Post-Quantum Computing para Ciberseguridad que comenzará el 9 de Noviembre. Pues bien, ya estamos en la tercera edición del mismo, que las dos ediciones anteriores estuvieron llenas, y tuvieron una aceptación y una valoración por parte de los alumnos espectacular. Así que, vamos a por una nueva este año.
La formación será 100% online, y la daré con mis compañeros de mil proyectos, y además de Pablo García Bringas y de mí, estarán Carmen Torrano, Fran Ramírez, Daniel Romero, Javier Álvarez y Pablo González, con alguna incorporación extra sorpresa que os contaré más adelante. Y el tipo de trabajos que se hacen, pues son como el de Blind Quantum Computing que os publiqué estos días que hizo uno de los alumnos.

La formación la hemos querido hacer, además de teórica, muy práctica en todo lo que tiene que ver con las actuaciones que estamos haciendo hoy en día en el mundo de la ciberseguridad con las tecnologías de Post-Quantum Cryptography. Hemos dividido la formación en nueve módulos que tenéis aquí.

Además, todos los asistentes recibirán el libro de "Quatum Security: Tecnología Cuántica & Ciberseguridad.Criptográfica Cuántica y Post-Cuántica" que hemos escrito sobre estos temas junto con la Universidad de Deusto, que tenemos listo para todos los asistentes, y que además se puede adquirir en 0xWord. 
Y por supuesto, los alumnos llevarán sus Tempos de MyPublicInbox. Para matricularte, lo puedes hacer desde la web.
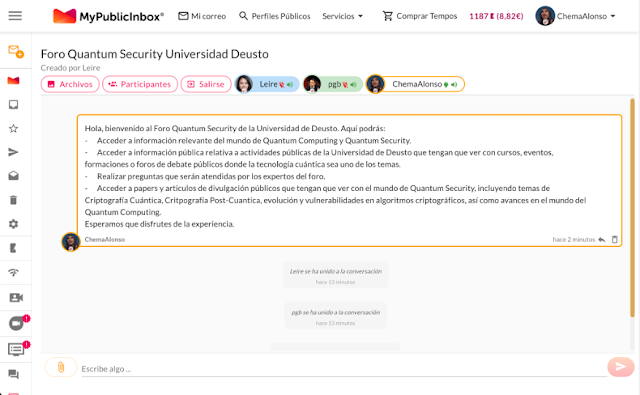
Una de las cosas que hemos hecho también, y en este caso podéis participar todos, es la creación de un Foro Online Público que funciona desde Septiembre del año pasado en MyPublicInbox, donde se comparten temas de Quantum & Post-Quantum Security, así que si quieres estar informado puedes entrar libremente y suscribirte.
Si vas a estar en el foro, te recomiendo que te bajes la app de MyPublicInbox para iPhone o la app de MyPublicInbox para Android, para que te sea más fácil seguir la conversación desde tu teléfono en cualquier momento. 

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


sábado, agosto 22, 2026

Cómo se desmontó el algoritmo que amenazaba a la Criptografía Post Cuántica 9 días después

En el artículo anterior os contaba que el 6 de agosto de 2026 apareció en el archivo ePrint de la IACR un manuscrito de Daniel R. Simon, del grupo de Criptografía de AmazonWeb Services, que afirmaba haber resuelto en tiempo polinómico el Problema del CosetDiedral. Si aquello era cierto, por una reducción que Oded Regev demostró en 2004 caía en cascada la seguridad teórica de toda la familia de los retículos, y con ella la de ML-KEM y ML-DSA, es decir, la de los dos algoritmos que el mundo entero está desplegando ahora mismo para sobrevivir a la llegada de los ordenadores cuánticos.

Figura 1: Cómo se desmontó el algoritmo que amenazaba
a la Criptografía Post Cuántica 9 días después

Aquel artículo lo cerré en el peor momento posible: con el manuscrito recién colgado, la comunidad criptográfica abriéndolo en fin de semana y nadie en condiciones de decir todavía si aquello se sostenía o no. Lo que ocurrió a partir de ahí es, en mi opinión, bastante más interesante que el propio anuncio.

Figura 2: Los nueve días, de un vistazo. Del envío del preprint
al resultado de imposibilidad verificado por máquina

Así que os ahorro la intriga, porque el final no es lo importante: el trabajo no era correcto. Lo que merece la pena contar es cómo se demostró que lo era, en cuánto tiempo y con qué herramientas. Desde que el manuscrito se hizo público hasta que quedó formalmente descartado pasaron nueve días. Nueve. Sin comités, sin revisión por pares a seis meses vista y con todo el proceso a la vista de cualquiera que quisiera mirar.

Un recordatorio de treinta segundos: dónde estaba la dificultad

Para que lo que viene se entienda, hay que tener presente una sola idea del artículo anterior. En un algoritmo cuántico la respuesta casi nunca está guardada en un sitio concreto: está repartida en las fases relativas entre todas las ramas de la superposición. Es una propiedad del conjunto, no de ninguna pieza suelta.

Durante el cálculo se van acumulando restos, información residual enganchada al estado que hay que borrar para que las amplitudes puedan volver a interferir entre sí. Y ahí está el problema: si borráis esa basura midiéndola, os lleváis la fase por delante. Es como intentar desmontar el andamio de un edificio sin tocar el edificio. Regev resolvía esa papeleta suponiendo un oráculo de suma de subconjuntos, una caja negra que nadie sabe construir. La aportación de Simon consistía, precisamente, en prescindir de ella. 

Retened la palabra andamio. Va a volver.

El fin de semana siguiente: la comunidad se pone a leer

Aquí es donde el episodio resulta más revelador, porque enseña cómo funciona de verdad la ciencia cuando nadie la está mirando desde fuera.

El manuscrito se hizo público un jueves. El fin de semana siguiente ya había criptógrafos leyéndolo con el lápiz en la mano y comentando en abierto lo que iban encontrando, y la discusión se concentró enseguida en unos pocos resultados intermedios del artículo, muy enparticular en el Lema 3. 

No voy a poner aquí frases entrecomilladas ni a atribuir juicios técnicos concretos a nadie, porque buena parte de aquella conversación ocurrió en canales y foros que no dejan un enlace estable al que poder apuntaros, y prefiero no atribuir a un investigador una frase que no pueda enseñaros. Lo que sí podéis comprobar vosotros mismos, y no depende de que nadie os lo cuente, es lo que trae el propio manuscrito.


Cuatro de los resultados que sostienen el teorema principal llevan sus demostraciones marcadas como ”(Sketch)”: el Lema 1 en la página 7, el Lema 3 en la 11, el corolario del Lema 3 en la 12 y el Lema 4 en la 13. El único de los lemas centrales que viene con demostración completa es el Lema 2. Dicho de otro modo: en un paper que reclama tumbar los cimientos de la Criptografía Post-Cuántica mundial, ninguna de las piezas críticas venía demostrada del todo. El 11 de agosto Simon subió una versión revisada del manuscrito, y esa es la que hoy encontraréis en ePrint. Cuatro días después llegó el golpe definitivo.


Fijaos en un detalle que se pierde con facilidad: aquí hay dos modos de refutación encadenados, y son cualitativamente distintos. Primero, la comunidad encuentra errores en las demostraciones, que en principio son reparables. Después, tres investigadores demuestran algo mucho más fuerte. Ver las dos cosas ocurrir en menos de una semana, en abierto y a la vista de todos, es una lección de método científico que difícilmente encontraréis mejor contada en un libro de texto.

Día 15: no encontraron el error, demostraron que no hay arreglo

El 15 de agosto, Aparna Gupte (MIT), Seyoon Ragavan (Google Quantum AI y MIT) y Mark Zhandry (Google Quantum AI y Stanford) publicaron una nota demoledora. Y conviene fijarse bien en el matiz, porque es lo más importante de todo el artículo: No encontraron un error en la demostración. Demostraron que el algoritmo no puede funcionar.

La diferencia es abismal: un fallo en una demostración se parchea, pero un resultado de imposibilidad no deja nada que parchear. Lo dicen ellos mismos en el abstract, sin rodeos: 

”We are showing directly that the algorithm cannot possibly work”. 

No están hablando del análisis que Simon hace de su algoritmo, están mostrando directamente que el algoritmo no puede funcionar. 

¿Y cuál es el argumento? Volvamos al andamio.

Durante el proceso, el algoritmo genera unas etiquetas clásicas al aplicar la Transformada de Fourier, y las utiliza por última vez en el tercer paso del procedimiento, únicamente para calcular unos pocos bits altos de cada bloque. A partir de ahí no vuelven a aparecer.

Los autores demuestran que, en consecuencia, todo el estado del algoritmo se puede reconstruir con un error minúsculo, del orden de poly(n) 2−n/3, empleando solo el tercio más significativo de esas etiquetas. Dos tercios de la información se descartan por el camino. Y aquí está la clave: esas etiquetas eran precisamente lo que mantenía la coherencia entre las distintas ramas de la superposición, y en esa coherencia era donde vivía el secreto. El andamio era el edificio.

Figura 7: La idea del argumento. Mientras el algoritmo conserva
las etiquetas de Fourier, las ramas de la superposición mantienen
una relación de fase definida y el secreto es recuperable. Al
descartarlas, esa relación se pierde y con ella toda la información

El teorema que demuestran es además más general que el algoritmo de Simon: cualquier procedimiento que siga la plantilla de Regev y descarte suficiente información sobre esas etiquetas resulta incapaz de distinguir el último bit del secreto con ventaja apreciable, por sofisticado que sea el post-procesado posterior. No es que Simon lo hiciera mal: es que por ese camino no se puede pasar. Si habéis estudiado algo de física, el argumento os resultará familiar, porque es del mismo tipo que un límite fundamental de medida. Si la información ya no está en el sistema, no hay procesado que la recupere.


Lo que el paper enuncia formalmente es una disyuntiva: o el algoritmo tarda del orden de 2n/9 en promedio para al menos uno de los dos secretos, o su ventaja al distinguirlos es a lo sumo poly(n) 2−n/9. Las dos cosas a la vez no pueden ser. Bernstein comprimió despuésesa disyuntiva en una sola cifra en su microblog: el cociente entre coste y probabilidad de éxito del algoritmo sería de al menos 2n/9. Exponencial, no polinómico.

Figura 9: Lo que el paper prometía frente a lo que la refutación demuestra.
Un algoritmo cuyo coste crece como 2n/9 no es un algoritmo eficiente
en ningún sentido útil de la palabra

Los autores son además escrupulosamente honestos: dicen que no conocen ninguna vía de reparación que esquive su teorema de forma significativa, pero se abstienen de afirmar que no exista. Y dejan una moraleja constructiva para quien quiera seguir intentándolo, que cualquier algoritmo para el DCP que siga la plantilla de Regev tendrá probablemente que usar las etiquetas de Fourier casi enteras durante la fase de descomputación.


Y hay un último detalle que dice mucho de cómo funciona esta comunidad: en los agradecimientos de la refutación, los tres autores dan las gracias, entre otros, al propio Daniel R. Simon. No hay aquí ningún ánimo de humillar a nadie.

El detalle friki: la refutación viene con código (y con IA)

Llegamos ahora a la parte que a mí me parece la más significativa de todo el episodio, aunque no salga en los titulares. Gupte, Ragavan y Zhandry no se limitaron a publicar un PDF con su argumento. Publicaron también un repositorio con una especificación en Lean 4 del algoritmo de Simon y las demostraciones verificadas por máquina tanto del teorema principal como del corolario de imposibilidad. Cualquiera puede descargarlo, compilarlo y comprobar que el argumento cierra sin tener que fiarse de la buena fe de nadie.


Y no es una formalización de escaparate. En los 83 ficheros .lean del repositorio no aparece ni un solo sorry —la palabra con la que Lean marca un hueco que aún hay que demostrar— ni un solo axioma propio: cero objetivos sin resolver y cero atajos. Lo he comprobado clonando el repositorio y pasando el rastreo que los propios autores documentan en su README, que busca sorry, admit, axiom y compañía y debe salir vacío. Sale vacío. El mismo fichero añade una auditoría de axiomas del núcleo sobre los tres teoremas principales, cuyo resultado solo puede contener los principios lógicos estándar que Lean y Mathlib arrastran de serie —propext, Classical.choice y Quot.sound—, nunca uno inventado para la ocasión.

Y aquí se cierra el círculo con el que abría el primer artículo. En la declaración sobre uso de inteligencia artificial que incluyen en su nota, los autores cuentan que la versión general de su teorema(la que convierte una refutación puntual en un resultado de imposibilidad amplio) la encontraron conversando con modelos de lenguaje, y que emplearon esos mismos modelos para producir la formalización en Lean, asumiendo ellos toda la responsabilidad sobre la corrección del resultado. El propio README del repositorio lo repite en una sola línea: la formalización se preparó con ayuda de un modelo. No es una interpretación mía. Lo dicen ellos, con nombres y apellidos, en un párrafo del propio paper:


Merece la pena detenerse un momento en esto. Hace unas semanas os contaba en el en el artículo de "Claude Mythos Preview debilita los algoritmos criptográficos PQC HAWK y AES con nuevos ataques" que la IA había encontrado grietas reales en algoritmos criptográficos, y yo terminaba aquel artículo preguntándome qué pasaría el día que apareciese una grieta en un candado de verdad. Pues bien: la grieta llegó, y la IA no estaba en el bando que yo esperaba.

Estaba ayudando a demostrar que la grieta no existía. Ideas propuestas con ayuda de una máquina, verificadas por otra máquina, publicadas en abierto y todo ello en menos de dos semanas. Hace diez años esto habrían sido meses de correos cruzados entre departamentos de medio mundo. Si alguien os pregunta alguna vez para qué sirven los asistentes de demostración formal, este es el ejemplo que hay que dar.

Entonces, ¿hay que preocuparse?

La respuesta corta es que no. Los supuestos de dificultad sobre los que descansan ML-KEM y ML-DSA están exactamente donde estaban el 2 de agosto: ningún algoritmo estandarizado roto, ningún ataque calculado contra ningún conjunto de parámetros y ningún despliegue que haya que pausar.

La respuesta larga es más incómoda, y es la que de verdad deberíamos llevarnos a casa. Durante nueve días, mucha gente responsable de infraestructura crítica descubrió que su plan de migración postcuántica dependía por completo de una única rama de las matemáticas. Que el susto fuera falso no cambia el hecho de que era estructuralmente posible, y la puerta que Regev construyó en 2004 sigue ahí, abierta y señalizada. Que este intento de cruzarla haya fracasado no dice nada sobre el siguiente.


Por eso conviene fijarse en quién estaba mejor preparado. El BSI alemán lleva añosempujando la hibridación como norma —su posición es que la criptografía postcuántica se despliegue siempre junto a RSA o Curva Elíptica, no en solitario— y mantiene en su guía técnica esquemas ajenos a los retículos estructurados, como Classic McEliece, basado en códigos. 


De esos nueve, ocho no están basados en retículos. Hay isogenias (SQIsign),MPC-in-the-Head (MQOM, SDitH), multivariantes (UOV, MAYO, QR-UOV, SNOVA) yesquemas simétricos (FAEST). El único de la familia de los retículos era HAWK, y ya nisiquiera sigue en pie: su equipo lo retiró de la competición este mismo verano, después deque Mythos le encontrara una simetría oculta —un automorfismo no trivial en el retículo— que rebaja el coste de recuperar una clave de HAWK-256 de 2 elevado a 64 a 2 elevado a 38 y obliga a doblar el tamaño de clave para mantener el nivel de seguridad prometido. Si entráis hoy en la página del NIST, HAWK figura expresamente como retirado.

Dicho de otro modo: la tercera ronda de firmas adicionales del NIST es, a día de hoy, una ronda enteramente ajena a los retículos. La red de seguridad existe y está tejida a propósito, y el último hilo que quedaba de la familia sospechosa se soltó él solo apenas unas semanas antes de que Simon subiera nada a ePrint. Nadie podrá decir que no lo habían pensado. La pregunta abierta, y no es retórica, es si esa tubería se movería lo bastante rápido el día que la contingencia sea de verdad.

Conclusión

Este episodio no ha demostrado que la criptografía de retículos sea frágil. Ha demostrado algo mucho más valioso: que la comunidad que la vigila es rapidísima, transparente y capaz de autocorregirse en cuestión de días. Un investigador de primer nivel lanzó una piedra enorme al estanque, la comunidad se puso a leer el fin de semana, tres investigadores demostraron con ayuda de una máquina que la piedra no llegaba al fondo, publicaron la prueba en abierto para que cualquiera pueda compilarla, y le dieron las gracias al que la había tirado. 

Eso es exactamente lo que uno espera de quienes custodian los cimientos matemáticos de Internet. La próxima vez, sin embargo, puede que la piedra sí llegue al fondo.Y entonces la pregunta ya no será si nuestros retículos aguantan, sino si tuvimos la prudencia de no apostarlo todo a una sola rejilla. Porque construir el futuro de la criptografía sobre un único pilar, por muy bien pintado que esté, sigue siendo construir sobre un único pilar. ¿Y si el próximo que venga a ponerlo a prueba no se equivoca? 


Otros artículos sobre Quantum Computing publicados:

viernes, agosto 21, 2026

El algoritmo que amenazó a la Criptografía Post-Cuántica

Hace poco os contaba en este blog cómo una inteligencia artificial se había sentado, por primera vez y por derecho propio, en la mesa de los criptoanalistas en el artículo de "Claude Mythos Preview debilita los algoritmos criptográficos PQC HAWK y AES con nuevos ataques". Terminaba aquel artículo con una pregunta que entonces me pareció puramente retórica sobre si ¿estarán nuestros candados preparados para un mundo donde las máquinas buscan las grietas?

No han sido las máquinas, pero la pregunta resultó tener una fecha de caducidad muy corta en forma de respuesta aviso. El susto llegó a principios de agosto de 2026, y de la mano de alguien a quien nadie en este campo puede tomarse a la ligera. Esta historia os la voy a contar en dos partes,


La primera mitad de la historia, ésta, donde os voy a contar qué se anunció exactamente, por qué era tan serio y por qué, aun así, ninguna persona sensata salió corriendo a apagar los servidores. La segunda mitad de la historia, será sobre cómo la comunidad lo desmontó en nueve días, y con una ayuda bastante inesperada, y os la contaré en el próximo artículo.

El hombre que ya rompió la criptografía una vez

El autor del preprint no es un aficionado que ha leído tres entradas de la Wikipedia. Es Daniel R. Simon, del grupo de Criptografía de Amazon Web Services, y su apellido os resultará familiar si habéis pasado por cualquier curso de computación cuántica: en 1994 publicó el algoritmo de Simon, uno de los primeros resultados que demostró de forma limpia una separación exponencial entre lo que puede hacer un ordenador clásico y lo que puede hacer uno cuántico.


Aquel resultado no rompía nada por sí solo, porque el problema que resolvía era artificial, inventado a propósito para el argumento. Pero fue la chispa: Peter Shor lo leyó, entendió la maquinaria que había debajo y ese mismo año publicó su algoritmo, el que factoriza números grandes en tiempo polinómico y el que hará saltar por los aires RSA y la Criptografía de Curva Elíptica en cuanto tengamos la máquina cuántica.

Figura 4: Algoritmo de Shor en Wikipedia en Español.
Causante de que el RSA sea inseguro con la llegada de los ordenadores cuánticos

Tenemos, por tanto, a la persona que inspiró el algoritmo destinado a acabar con la criptografía actual regresando treinta y dos años después, esta vez sobre el sustituto. La simetría es demasiado buena para ser casualidad, y explica en buena medida por qué nadie se tomó este preprint a la ligera.

Un repaso rápido: por qué lo hemos apostado casi todo a una rejilla (los algoritmos lattice-based )

Los dos algoritmos de propósito general que el mundo entero está desplegando ahora mismo, ML-KEM (antes Kyber) y ML-DSA (antes Dilithium), pertenecen a la misma familia: los retículos. No es que el NIST no tuviera otras cartas —SLH-DSA, el antiguo SPHINCS+, se apoya solo en funciones hash y no toca un retículo ni de lejos—, pero el peso real de la migración recae sobre esos ML-KEM y ML.DSA. Y el tercer algoritmo que viene en camino, FN-DSA (el antiguo Falcon), también está basado e retículos, aunque de un tipo distinto.
También es importante citar en esta parte de la historia a Frodo-KEM, que para librarse del "anillo" de los retículos por si algún día aparecía una debilidad matemática en ellos, hubiera otra alternativa. Por eso le llamaron Frodo, en honor a "Lord of the Ring", que es el hobbit más famoso de la historia luchando por librarse de un anillo.


Un retículo es, en el fondo, una rejilla de puntos. Pensad en el papel milimetrado, pero en mil dimensiones y torcido, definido por una base de vectores que no son perpendiculares entre sí ni miden lo mismo. Sobre esa rejilla se plantean los dos problemas de siempre. 

El SVP pide encontrar el punto más cercano al origen sin ser el origen: en dos dimensiones lo resolvéis mirando el dibujo, en mil y con una base torcida es una pesadilla. Y el LWE os entrega un puñado de ecuaciones lineales cuya solución es la clave secreta, pero con un ruido pequeño sumado a cada una: sin ruido lo resuelve un estudiante de primero con Gauss, con ruido se convierte en una sopa de letras.

La gracia de estos problemas es que generarlos resulta trivial, resolverlos parece imposible y, sobre todo, que nadie conocía un atajo cuántico. Shor destroza la factorización porque esta esconde una estructura periódica muy concreta que la transformada cuántica de Fourier detecta a la primera. Los retículos, en principio, no tienen esa estructura tan amable.

Figura 7: El mismo retículo con dos bases distintas: la ”buena” (vectores
cortos y casi perpendiculares) y la ”mala” (largos y casi paralelos). 

Es la intuición clásica de por qué un retículo puede esconder un secreto, aunque conviene no tomarla al pie de la letra: la clave pública de ML-KEM no es literalmente una base mala, sino un sistema de ecuaciones con ruido

La puerta que Regev dejó construida en 2004

Aquí entra el protagonista técnico de la historia, con un nombre diseñado para espantar lectores: el Problema del Coset Diedral, o DCP por sus siglas en inglés. Conviene traducirlo.

Existe una familia enorme de problemas llamada problema del subgrupo oculto, y resulta que casi todos los grandes éxitos de la computación cuántica son casos particulares de ella. El algoritmo de Shor es un problema de subgrupo oculto sobre un Grupo Abeliano, es decir, conmutativo, de los ”fáciles”. El de Simon de 1994, también. Los ordenadores cuánticos son extraordinariamente eficaces en ese terreno, porque la transformada de Fourier diagonaliza esos grupos y la interferencia se encarga del resto.

El grupo diedral (el de las simetrías de un polígono: rotaciones y reflexiones) no conmuta. Girar y luego reflejar no es lo mismo que reflejar y luego girar, y ahí es donde el método se atasca. En su versión de Coset, el problema queda planteado así: recibes muchísimos estados cuánticos, cada uno de ellos una superposición de | 0, x ⟩ y | 1, x + s ⟩, con x distinto en cada muestra y s un valor secreto que se repite en todas. Tu misión, si decides aceptarla, es recuperar s.


¿Y qué tiene esto que ver con los retículos?  En 2004, Oded Regev demostró una reducción: quien supiera resolver el DCP de forma eficiente, sabría resolver ciertos problemas difíciles de retículos. Esa reducción es incondicional, no depende de ninguna suposición extra, y en 2018 Brakerski, Kirshanova, Stehlé y Wen la afinaron todavía más, conectando el LWE con una variante extrapolada del mismo problema diedral. La puerta llevaba veinte años construida y señalizada.

Lo que faltaba era la llave: un algoritmo eficiente para el DCP. Y aquí es donde aparece el famoso oráculo, que conviene situar bien porque medio Internet lo colocó en el sitio equivocado. En un trabajo distinto del anterior, el propio Regev dio también un procedimiento en tiempo polinómico para resolver el DCP, pero suponiendo acceso a un oráculo de suma de subconjuntos: una cajita mágica capaz de resolver otro problema difícil que nadie sabe resolver. Es como decir que sabes llegar a Marte suponiendo que alguien te presta una nave que llega a Marte.


Fijaos bien en dónde queda el hueco, porque es la clave de todo: el tramo que va del DCP hasta los retículos está entero. Lo que nadie tenía era la primera pieza, un algoritmo real para el DCP. Y el mejor conocido, el de Greg Kuperberg (2005), corría en tiempo subexponencial: mucho mejor que la fuerza bruta, pero muy lejos de polinómico.


El tramo que va del DCP hasta ML-KEM y ML-DSA está completo y demostrado; la pieza que faltaba estaba justo antes, un algoritmo eficiente para el DCP que no dependiese de un oráculo 

Lo que decía el paper: quitar el andamio sin tirar el edificio.

El 3 de agosto Simon subió a ePrint un manuscrito titulado "A Polynomial-Time QuantumAlgorithm for the Dihedral Coset Problem". La IACR lo aprobó y lo publicó el día 6 de Agosto, que es cuando la prensa especializada se hizo eco, y el paper fue revisado el día 11 de Agosto. Lo que afirmaba era exactamente la llave que faltaba: resolver el DCP en tiempo polinómico sin necesidad del oráculo.


La dificultad que hay que salvar es más sutil de lo que parece, y merece la pena entenderla bien, porque va a ser la clave de todo lo que os cuente en el próximo artículo. En un algoritmo cuántico la respuesta casi nunca está guardada en un sitio concreto: está repartida en las fases relativas entre todas las ramas de la superposición. Es una propiedad del conjunto, no de ninguna pieza suelta. Y a lo largo del cálculo se van acumulando restos, información residual enganchada al estado que hay que borrar para que las amplitudes puedan volver a interferir entre sí. El problema es que, si borráis esa basura midiéndola, os lleváis la fase por delante. Es como intentar desmontar el andamio de un edificio sin tocar el edificio.


La propuesta de Simon consistía en dividir las muestras en bloques y procesarlos de forma que unos quedasen limpios de fases indeseadas mientras los demás se apartaban dejando el estado casi equilibrado. Después se transfiere a un qubit de repuesto la fase que codifica un bit del secreto y se repite el proceso de manera recursiva.


El artículo subrayaba además un detalle: el algoritmo afirmaba tolerar muestras defectuosas hasta una tasa de 1/O(log n). La idea es que las reducciones que van desde los retículos hasta el DCP pueden introducir ese tipo de basura, y el algoritmo de Kuperberg exige muestras limpias.

Conviene decir, eso sí, que este punto fue discutido de inmediato: Elena Kirshanova, coautora del trabajo de 2018 sobre el que se apoya toda la reducción, señaló que la tolerancia al ruido no llega a usarse en ningún momento del paper, porque las reducciones existentes ya entregan muestras limpias en cantidad polinómica. Y la razón de fondo por la que el algoritmo de Kuperberg nunca inquietó a nadie es más simple: es subexponencial, y punto.

Con oráculo o sin él, el corolario final afirmaba resolver en tiempo polinómico aproximaciones al SVP con factor √n polylog(n) e instancias de LWE en el régimen equivalente. Traducido:

Un ordenador cuántico podría atacar de forma eficiente el problema que sostiene buena parte de la criptografía postcuántica.

Y aquí un detalle que parece menor y que va a resultar decisivo en el próximo artículo: ese corolario final, el que fija los parámetros concretos de SVP y LWE, no venía derivado en el manuscrito, sino atribuido a comunicaciones personales con Daniele Micciancio y Seyoon Ragavan. Guardad ese segundo nombre.

Por qué nadie salió corriendo a apagar los servidores

Y sin embargo la reacción de la comunidad no fue el pánico, sino una mezcla muy saludable de ”esto es enorme” y ”conviene mantener la calma”. Merece la pena entender por qué, porque aquí hay una lección práctica sobre cómo leer titulares tecnológicos.

1. Aproximado no es exacto: El resultado no encontraba el vector más corto, sino uno razonablemente corto. De ahí a ”te recupero esta clave de ML-KEM” hay un trecho considerable.

2. Peor caso frente a caso medio, y una capa más: Los problemas de retículos que aparecen en las reducciones son de peor caso; los que protegen vuestro navegador son instancias medias con parámetros muy concretos. Y hay un salto adicional: ML-KEM y ML-DSA no descansan sobre LWE a secas, sino sobre Module-LWE, que arrastra estructura algebraica extra.

3. Polinómico no significa práctico: El propio análisis del paper exige una constante c ≥12, lo que se traduce en del orden de n13 muestras. Comparadlo con el coste cúbico del algoritmo de Shor. Un polinomio de grado trece es polinómico igual que ir andando a la Luna es una distancia finita.

4. No había estimación de recursos: Ni qubits lógicos, ni puertas, ni profundidad de circuito, ni operaciones corregidas de errores. Nada.

5. Era un preprint: Sin revisión por pares, con el propio autor calificándolo de preliminar en el título, con cuatro de sus lemas presentados explícitamente como esbozos ”Proof. (Sketch)”.

Al segundo punto, eso sí, le habían quitado bastante fuelle apenas unos días antes, y esto casi nadie lo contó. Weiqiang Wen y Jinwei Zheng, de Télécom Paris, publicaron un trabajo ya revisado por pares y aceptado en CRYPTO 2026 en el que demuestran una equivalencia cuántica en tiempo polinómico entre Module-LWE y una variante estructuradadel problema diedral extrapolado. 
Wen es coautor del artículo de 2018 sobre el que se apoya la reducción de Simon, así que no hablamos de dos grupos que llegan por casualidad al mismo sitio, sino de la misma línea de investigación avanzando. El puente hasta el supuesto de dificultad que hay debajo de ML-KEM era, de repente, más corto de lo que parecía la semana anterior.

Quien sí quedaba fuera de esta vía concreta es FN-DSA (el antiguo Falcon), que se apoya en retículos NTRU y para el que no se conoce ninguna reducción publicada que lo conecte con el DCP. Si el resultado hubiera sido correcto, habría supuesto un avance mayúsculo de complejidad teórica y un aviso muy serio sobre los cimientos. Pero no era un ataque: nadie tenía motivos para detener su migración a ML-KEM, y a día de hoy sigue sin haberlos.

Y entonces la comunidad se puso a leer

Un preprint de este calado no se queda quieto mucho tiempo. El fin de semana siguiente a su publicación, criptógrafos de primer nivel ya tenían el manuscrito abierto y el lápiz en la mano, y para el 15 de agosto el asunto estaba cerrado.


Lo interesante no es que encontraran un error. Es que hicieron algo bastante más definitivo, y lo hicieron con una herramienta que hasta hace muy poco no habría estado sobre la mesa. Pero eso, junto con la respuesta a la pregunta con la que abría este artículo, os lo cuento en el próximo.


Otros artículos sobre Quantum Computing publicados:

Entrada destacada

Hacking IA: Jailbreak, Prompt Injection, Hallucinations & Unalignment. Nuestro nuevo libro en 0xWord

Pocas veces me ha hecho tanta ilusión que saliera un nuevo libro en 0xWord como con este libro de " Hacking IA: Jailbreak, Prompt Inje...

Entradas populares