Mostrando entradas con la etiqueta hash. Mostrar todas las entradas

viernes, mayo 29, 2026

Los Papers Académicos de los algoritmos PQC de Autenticación y Firma Digital en la Ronda 3 del NIST

Recientemente el NIST hizo la selección de los nueve algoritmos de Firma Digital y Autenticación Post-Cuántica (PQC) que han avanzado a la Tercera Ronda del proceso de estandarización de firmas adicionales del NIST. Por supuesto, quería estudiarlos un poco, y aprender cómo funcionan, así que he estado buscando sus papers y leyendo un rato sobre ellos.

Figura 1: Los Papers Académicos de los algoritmos PQC de
Autenticación y Firma Digital en la Ronda 3 del NIST

Aún me queda mucho que leer, y el proceso irá avanzando, pero mientras que sigo aprendiendo algo de ellos, os dejo aquí la colección de papers académicos, y especificaciones técnicas de cada uno de ellos, que saldrán en la siguiente edición del libro de Quantum Security cuando la construyamos. De todo ello hablé en su momento en el Foro de Ciberseguridad que llevo en MyPublicInbox, por si quieres apuntarte.


A continuación tienes la lista de los nueve algoritmos, con una muy breve descripción de los mismos, y los enlaces a los papers académicos, para que comiences tú a leer sobre ellos hoy mismo, que el mundo PQC está ya aquí.

1. FAEST

Basado en el paradigma VOLE-in-the-Head y funciones simétricas probadas como AES, ofreciendo una seguridad matemática muy robusta. Destaca por tener claves públicas y privadas extremadamente pequeñas, ocupando apenas unas pocas decenas de bytes. Sus firmas son de tamaño moderado, aunque requiere un esfuerzo computacional mayor en los procesos de firma y verificación.
    2. HAWK

    HAWK es un esquema de firma digital (utilizado para autenticación) basado en retículos (lattices). Es especialmente relevante porque fue seleccionado por el NIST (Instituto Nacional de Estándares y Tecnología de EE. UU.) para avanzar a la Ronda 2 del proceso de estandarización de firmas digitales adicionales de criptografía post-cuántica (PQC).

    3. MAYO

    Algoritmo multivariante basado en el esquema tradicional Oil and Vinegar (UOV), pero optimizado para entornos modernos. Logra claves públicas significativamente más pequeñas combinando los polinomios mediante una estructura matemática modificada. Mantiene firmas muy cortas y un proceso de verificación sumamente veloz, siendo ideal para dispositivos con hardware limitado.

    4. MQOM (MQ on my Mind)

    Utiliza el paradigma MPC-in-the-Head (computación multi-parte) aplicado al problema cuadrático multivariante (MQ). Su seguridad depende directamente de la dificultad de resolver sistemas de ecuaciones polinomiales que carecen de estructura cíclica. Genera claves públicas diminutas, aunque el tamaño de sus firmas es relativamente grande debido a las pruebas de conocimiento cero.

    Variante del clásico Unbalanced Oil and Vinegar que introduce anillos de cociente (QR) para estructurar la clave pública. Consigue reducir drásticamente el descomunal tamaño de las claves del UOV tradicional mediante el uso de matrices cíclicas. Conserva intactas las grandes ventajas del esquema original: firmas ultra cortas y una altísima velocidad de verificación.
    6. SDitH (Syndrome-Decoding-in-the-Head)

    Utiliza la técnica Syndrome Decoding in the Head, uniendo códigos correctores de errores con pruebas de conocimiento cero. Su seguridad descansa sobre el problema de decodificación por síndrome, un pilar de la criptografía basada en códigos muy estudiado. Ofrece claves públicas compactas y un rendimiento equilibrado, a cambio de generar firmas de tamaño moderado-alto.


    7. SNOVA

    Esquema multivariante no conmutativo que aplica la estructura de UOV sobre álgebras matriciales en vez de campos finitos. Esta innovación matemática permite encoger drásticamente las claves públicas en comparación con cualquier UOV estándar. Produce firmas pequeñas y procesos rápidos, posicionándose como una alternativa muy eficiente para sistemas con restricciones de memoria.

    8. SQIsign 

    Basado en isogenias de curvas elípticas supersingulares, destaca por ofrecer las firmas más pequeñas de toda la criptografía post-cuántica. Sus claves públicas son también diminutas, lo que optimiza al máximo el uso de ancho de banda en las comunicaciones de red. El principal inconveniente es su alta carga computacional, requiriendo algoritmos matemáticos complejos y lentos para firmar.

    9. UOV (Unbalanced Oil and Vinegar)

    Esquema multivariante clásico (Unbalanced Oil and Vinegar) que cuenta con décadas de madurez y un análisis de seguridad muy estable. Genera firmas extremadamente cortas y ofrece una de las velocidades de verificación más rápidas de la competencia. Su gran desventaja radica en el enorme tamaño de sus claves públicas, las cuales requieren decenas de kilobytes para operar.
    Si te interesan estos temas, te recomiendo que te apuntes al Foro Online Público que funciona desde Septiembre del año pasado en MyPublicInbox, donde se comparten temas de Quantum & Post-Quantum Securrity, así que si quieres estar informado puedes entrar libremente y suscribirte.
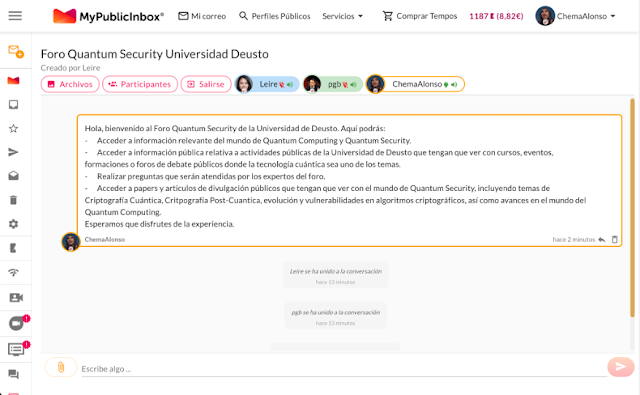
    Si vas a estar en el foro, te recomiendo que te bajes la app de MyPublicInbox para iPhone o la app de MyPublicInbox para Android, para que te sea más fácil seguir la conversación desde tu teléfono en cualquier momento. Además, aquí te dejo todos los artículos que he publicado en este blog sobre estos temas por si quieres leer con calma todo. 
    Espero que estos temas te estimulen a ir haciendo cada día más cosas con las tecnologías alrededor del mundo cuántico, porque cada día vamos a ver nuevos avances al respecto. 

    ¡Saludos Malignos!

    Autor: Chema Alonso (Contactar con Chema Alonso)  


    martes, marzo 18, 2025

    ¡Cloned Voice Detector! & HashVoice: Sellado de audios con esteganografía

    De la charla que di en RootedCON 2025 titulada "Laife gets better", donde utilicé una serie de películas de Ciencia Ficción con futuros distópicos como guión de la charla, os he contado ya las dos primeras partes, donde hablaba del BASIC 1.0 Copilot para AMSTRAD CPC 6128 y de Sentimetrics. Hoy quería hablaros de la siguiente parte, que también tiene que ver con detectar DeepFakes - en este caso de audio - y cómo firmar las voces legítimas.

    Figura 1: Cloned Voice Detector & HashVoice.
    Sellado de audios con esteganografía

    Dentro del proceso de detectar DeepFakes - o humanos digitales -, el audio es una pieza fundamental. De esto, en la charla de "Are you takin' to me?" le dedicamos mucho trabajo a detectar voces clonadas utilizando modelos de Machine Learning que nos ayudaran a clasificar en función del espectrograma del sonido. Toto lo tenéis en artículo que os dicho ""Are You Talkin' ta me?" DeepFake Voice en Español & Detección de Voces Clonadas".

    Figura 2: Libro de Machine Learning aplicado a Ciberseguridad de
    Carmen Torrano, Fran Ramírez, Paloma Recuero, José Torres y Santiago Hernández.

    Sin embargo, no siempre es necesario hacerlo con un entrenamiento "from Scratch", ya que algunas de las herramientas de clonación de voz, o de generación de contenido con IA, están utilizando técnicas de Watermarking para que se pueda saber siempre que ese fichero fue creado por ellos. Básicamente la técnica consiste en introducir una marca de agua invisible o inaudible para las personas, pero que ellos pueden localizar, para saber si alguien está usando sus servicios para algo malo, o haciendo un uso indebido de sus tecnologías.
    Una historia de esto es lo que hizo la mítica ATARI en el juego CENTIPEDE para demostrar después que le habían pirateado el código, añadiendo para ello un código ofuscado en Hexadecimal, que traspasado a Binario y convertido a Código Morse decía: "COPYRIGHT1980ATARI". Esta idea también la usan muchas de las herramientas de GenAI. 
    En el caso de audio, por ejemplo ElevenLabs tiene una herramienta que te dice cuando un fichero ha sido creado por ellos, que puedes usar en todo momento, y aunque a veces las manipulaciones del fichero de audio, su inclusión en vídeos, o la aplicación de efectos pueden modificar total o parcialmente, la suma de la búsqueda de las marcas de agua más la aplicación de los modelos de Machine Learning, te dan un buen grado de confianza en esos casos.

    Cloned Voice Detector

    Esto, llevado a data-sets en los que se pueden tener metadatos de con qué herramienta ha sido generado el audio, hace que los detectores de voces clonadas hechos con Machine Learning funcione bastante bien, y luego, una vez entrenados muchos modelos entrenados por herramientas, puedes tener un grado de acierto alto, además de llegar hasta descubrir la marca de agua. 

    Figura 5: Cloned Voice Detector

    Para nuestros trabajos internos, hemos estado trabajando en Cloned Voice Detector, una plataforma nuestra que nos permite saber vía web o vía API si un audio ha sido clonado o no, que funciona tan sencillo como lo que ves en el vídeo. No es 100% perfecto, pero es una capa de seguridad extra que nos permite verificar la voz en muchos sitios.

    HashVoice

    Ahora vamos a la parte que queríamos hacer, que con la idea del Watermarking lo que queríamos es que las personas pudieran firmar un audio pensando en poder detener la viralización de campañas de difamación, o falsas noticias por las plataformas sociales. De hecho, un estudio reciente dice que las plataformas de clonado de voz no ofrecen suficientes garantías y que tienen que ayudar a evitar el mal uso de sus tecnologías.

    Tiempo atrás pensamos que podríamos hacer algo para eso. Basada en la idea del proyecto Path4 de ElevenPaths. En ese proyecto se buscaba evitar que alguien encontrara un bug en la generación de certificados digitales o en la criptografía y que pudiera firmar malware con firmas legítimas. La idea era que cada vez que se firma legítimamente un programa este ser reporta a una base de datos, que mantiene el hash del binario, la marca de tiempo, el certificado utilizado, etcétera.  Así, cuando se comprueba la firma, se verifica que el hash del fichero y la firma están en el servidor de Path4 y si no... raise a flag!

    Figura 8: Registro de patente de HashVoice

    Con esta idea pensamos en hacer Hashvoice, que la acabamos de presentar el mismo día de la charla de la RootedCON 2025. Se trata de un sistema para firmar los ficheros de audio que se mandan en cualquier plataforma, con diferentes niveles de seguridad.
    • Biometría: Para poder validar que un mensaje de audio corresponde a un usuario y firmarlo, primero hay que hacer un onboarding biométrico de la voz. Al estilo de cómo se hace el onboarding de FaceID. La idea es poder validar primero la voz de la persona.
    • Detección de Cloned Voices: Por cada audio que se va a sellar se pasan por las APIs de Cloned Voices para detectar si se encuentran marcas de agua de herramientas de clonado de voces, si los algoritmos de Machine Learning de detección de voces clonadas, o de voces emitidas desde un altavoz en lugar de venir desde una persona, levantan alguna alerta.
    • Verificación multifactor: Asociado al servicio de firma se pueden hacer validaciones multifactor, como verificar el dispositivo con el API de Number Verification, información del perfil basada en contexto como horarios, metadatos, ubicaciones, etcétera, o incluso solicitud de un control de autorización para la firma en paralelo con una plataforma como Latch.
    Así, con todas esas verificaciones, se realiza el registro del audio, y se pasa al proceso de Sellado del mismo. Para ello, primero se genera la firma del fichero. Se transforma a formato WAV, se calcula el hash, y se genera un JWT (Jason Web Token) que contiene ese hash y el número de teléfono desde el que se ha generado (para este ejemplo hemos usado OpenGateway como verificación multifactor).

    Figura 9: HashVoice JWT

    Pero como esto sería un problema de privacidad al dejar el número de teléfono codificado en el JWT, lo que usamos es un JWE (Encrypted) que contiene el JWT, por lo que el resultado es el siguiente que podéis ver a continuación, donde no se puede acceder al contenido.

    Figura 10: HashVoice JWE

    Y ahora el sellado final, que se hace - a parte de guardar en la base de datos del servidor toda la información relativa a este audio - mediante el proceso de introducir un marca de agua en los ficheros de audio utilizando técnicas de esteganografía. En este caso, usamos LSB (Least Significant Bit) que es algo muy típico en imágenes, pero que también se puede hacer con los bits de la onda de audio para no afectar al contenido.

    Figura 11: Sellado de audio con HashVoice

    Una vez que queda sellado, en el fichero queda almacenada esa información para poder garantizar que ha sido grabado legítimamente, para que se pueda verificar, y para saber que no ha sido manipulado, de tal manera que sería una garantía de lo que se ha dicho para contrastar con una manipulación.

    Figura 12: Verificación de Sellado con HashVoice

    Esto permite, en un incidente, poder garantizar que el audio que ha sido enviado es el correcto, y que ha pasado todos los controles de verificación contra clonado de voces y verificación biométricas previos. Por supuesto, el sistema reconocería todas las situaciones:

    Figura 13: No se puede sellar el audio porque no pasa los controles
    de seguridad (Biometría, DeepFake Detector y Contexto)

    Figura 14: El fichero no contiene una firma válida

    Figura 15: El fichero tiene una firma alterada.

    Todo este trabajo lo que daría es un punto de información más para tomar una decisión ante la viralización de un audio, la publicación de una noticia, o el bloqueo de un contenido por su manipulación. Este tipo de herramientas van a ser cada día más necesarias.

    ¡Saludos Malignos!

    Autor: Chema Alonso (Contactar con Chema Alonso)  

    jueves, junio 20, 2024

    Microsoft declara oficialmente obsoleto el protocolo de autenticación NTLM en Windows

    Hace unos días, Microsoft anunció que finalmente optará por “deprecar” NTLM. Aunque esto pueda parecer un cambio drástico en la postura de Windows y su conocida retro-compatibilidad, lo cierto es que se trataba de “una muerte anunciada”. Este cambio era previsible, y tanto Microsoft como sus empleados lo han estado manifestando desde octubre de 2023 a través de diferentes medios. 

    Figura 1: Microsoft declara oficialmente obsoleto el protocolo
    de autenticación NTLM en Windows

    Podemos verlo en esta charla de Steve Syfuhs, Principal Engineer en Microsoft, y también en este post del blog de Microsoft escrito por Matthew Palko, donde ambos hablan de la evolución de la autenticación en Windows y cómo NTLM está quedando relegado por Kerberos. NTLM siempre ha sido uno de los grandes problemas de seguridad que obliga a tomar medidas de fortificación en Windows para evitar riesgos.
    Sin embargo, no ha sido hasta ahora, el 11 junio de 2024, que Microsoft, en su lista de funcionalidades “deprecated” para Windows ha anunciado oficialmente la desaparición y “deprecación” del mítico protocolo de autenticación NTLM, que será oficialmente reemplazado por Kerberos siempre que sea posible. Esto significa, que Microsoft dejará de mantener de forma activa este protocolo y priorizará el soporte de otros como Kerberos.


    Si bien en el anuncio se comenta que seguirá funcionando en la próxima versión de Windows Server y en la próxima versión anual de Windows, es cierto que todas las llamadas a NTLM deberían intentar autenticarse haciendo uso de Kerberos, de esta forma solo se recurriría a NTLM en los casos que sea estrictamente necesario.

    Funcionamiento y Riesgos de NTLM

    Ya sabéis que NTLM, tuvo un predecesor (y también unos cuantos sucesores o alternativas), todos conoceréis LM o LAN Manager. Este protocolo que nació en 1987 cuando Microsoft, junto con IBM, desarrollaban un sistema operativo de redes, el denominado OS/2. No tardaron en mostrarse al mundo las vulnerabilidades inherentes del algoritmo de hash LM. 

    Para crear estos hashes, comenzamos con la primera de las restricciones, contraseñas de un máximo de 14 caracteres. Luego, a pesar de permitir introducir mayúsculas y minúsculas, todas las letras se convertían a mayúsculas, por lo que el conjunto de caracteres se reducía a la mitad, y contraseñas como “HaCkEr” o “hacker” generaban el mismo hash. 

    Por último, y para más “inri”, se generaban dos hashes concatenados al segmentar la contraseña de 14 caracteres en dos de 7 caracteres cada una. El resultado, cómo podéis imaginar, todo un protocolo digno de aplicar un ataque de fuerza bruta. En la siguiente imagen os dejo una explicación básica de este algoritmo:


    Microsoft tenía que hacer algo, y nació NTLM (New Technology LAN Manager), el protocolo de autenticación sucesor de LAN Manager. Este protocolo, que apareció por primera vez en 1993 junto a Windows NT 3.1, utiliza un mecanismo de desafío-respuesta para autenticar a un cliente en un servidor mediante una contraseña. El flujo de funcionamiento de NTLM es el siguiente:

    1) El cliente comienza una negociación con un servidor y envía un NEGOTIATE_MESSAGE anunciando sus capacidades y características de seguridad soportadas. 
     
    2) Una vez negociados los detalles de la comunicación (por ejemplo, la versión de LDAP a utilizar), el servidor responde con un CHALLENGE_MESSAGE, que incluye un nonce (un número aleatorio) que el cliente tendrá que cifrar con el hash de su contraseña (que debe ser igual al hash NTLM guardado en la SAM). Este nonce es de 8 bytes en NTLMv1 y de 16 bytes en NTLMv2. 
     
    3) Tras esto, el cliente responde con un AUTHENTICATE_MESSAGE, que contiene el nonce cifrado con el hash NT de la contraseña del usuario, junto con otros datos de autenticación.
    • En el caso de un entorno de Active Directory, el servidor envía el desafío y la respuesta enviada por el cliente al controlador de dominio para que este verifique su validez.
    • El controlador de dominio verifica la respuesta y envía la confirmación de autenticación al servidor.
    4) Finalmente, si la verificación enviada por el controlador de dominio es correcta, el servidor validará correctamente al usuario o, por el contrario, devolverá un error.


    Como se puede comprobar, en este proceso de autenticación NTLM no se ha utilizado en ningún momento la contraseña del usuario de manera directa, sino que se emplea para crear su hash NTLM, hash que está almacenado en la SAM (Security Account Manager) del equipo. Debido a la ausencia de “salting” y que el hash NTLM y la contraseña son equivalentes a nivel de secreto en el protocolo NTLM, el conocido ataque PassTheHash tiene sentido. En este tipo de ataque, un atacante que ha obtenido el hash NTLM de un usuario puede autenticarse como ese usuario sin necesidad de conocer su contraseña en texto plano.
    Por último, comentar acerca del sucesor definitivo de NTLM, Kerberos, un protocolo de autenticación creado por el MIT en 1989, de código abierto y mantenido por una gran comunidad, entre la cual se encuentra Microsoft que desarrolla su propia versión (compatible en gran medida con la “oficial”).

    Kerberos, deja atrás el método de desafío-respuesta propio del protocolo de autenticación NTLM y pasa a utilizar un sistema de tickets para autenticar a los usuarios. En Kerberos encontramos componentes claves como el centro de distribución de claves (KDC), el servidor de autenticación (AS), el servidor de concesión de tickets (TGS), … Todo esto, da para verlo con más detalle en otro post.

    Figura 7: Misión de Kerberos.org

    La misión de Kerberos es establecerse como la plataforma universal de autenticación en todas las redes del mundo, así lo comentan kerberos.org. Actualmente, Kerberos es el protocolo de autenticación principal por defecto, mientras que NTLM interviene en circunstancias específicas. Por ejemplo, se utiliza NTLM cuando se autentica a través de sistemas configurados en un grupo de trabajo en lugar de un dominio, en la autenticación local en controladores que no forman parte de un dominio o en aplicaciones que no soportan otros tipos de protocolos.

    Tú mismo puedes hacer uso de un Fiddler (un proxy que registra todo el tráfico HTTP/HTTPS entre el equipo e Internet) para recopilar todas las peticiones realizadas, y mediante la observación de las cabeceras, detectar en qué casos se está usando Kerberos o NTLM. En una cabecera de autorización, si el token comienza por “YII” estaremos ante un caso donde se está utilizando Kerberos. Si, por el contrario, comienza por “TlR” estaremos ante un protocolo de autenticación distinto a Kerberos (normalmente NTLM). Por ejemplo:
    • Cabecera de autenticación de Kerberos:
      • Authorization: Negotiate YIIVDAYGKwYBE...
    • Cabecera de autenticación no perteneciente a Kerberos:
      • Authorization: Negotiate TlRMTVNTUA...
    Volviendo a la noticia, con este anuncio, Microsoft se ha comprometido a trabajar para eliminar y mitigar todos estos escenarios que hacen uso de NTLM en componentes de Windows, y en el momento que lo vean oportuno lo deshabilitaran por completo. Este movimiento ha provocado toda una ola de reacciones entre los usuarios. Algunos elogian este cambio, otros se preguntan por qué ahora y no hace 20 años, y otros defienden el uso de NTLM, criticando la falta de retro-compatibilidad que esta modificación implicará para los equipos más antiguos.

    Figura 8: Libro de Ethical Hacking 2ª Edición  de 0xWord
    escrito por Pablo González Pérez

    Ahora toca esperar y ver cómo Microsoft sigue moviendo ficha hasta que veamos por completo la eliminación de NTLM. No obstante, es un cambio positivo ya que pasamos de utilizar un protocolo de autenticación donde el conocimiento del hash del usuario rompe por completo la seguridad; a utilizar por defecto un protocolo más seguro como es Kerberos. Y para los Ethical Hacking, pues a ponerse las pilas con Pass-the-ticket.

    Saludos,

    Autor: Javier Álvarez Páramo (Investigador en el IdeasLocas)

    viernes, mayo 22, 2020

    Aplicaciones prácticas de Docker en ciberseguridad: Contenedores para “crackear” passwords utilizando GPU

    Continuamos con nuestra serie de artículos donde vamos publicando diferentes herramientas relacionadas con la ciberseguridad, eso sí, siempre con Docker como eje principal. En el primer artículo de esta serie contamos cómo crear nuestro propio Proxy para poder navegar por la red TOR. En esta ocasión, vamos a sacar partido a los contenedores Docker que también utilizan la GPU del equipo para romper o crackear contraseñas. 

    Figura 1: Aplicaciones prácticas de Docker en ciberseguridad:
    Contenedores para “crackear” passwords utilizando GPU


    De esta forma, de una manera limpia y sencilla, puedes desplegar este tipo de herramientas en tu ordenador durante un Ethical Hacking. Recuerda que un buen punto de partida para comenzar en el maravilloso mundo de Docker es nuestro libro Docker:SecDevOps ;)

    Figura 2: Libro de Docker:SecDevOps

    Como ya hemos comentado más de una vez, la gran ventaja de Docker es el poder desplegar en pocos segundos, cualquier aplicación que necesitemos sin tener que realizar cambios en nuestro ordenador principal. Vamos con el caso de hoy.

    Creando la imagen con doig (Docket Image Generator)

    Para crear la colección de herramientas que necesites puedes utilizar la herramienta de Tuxotron, llamada doig, que ya presentamos en el anterior artículo. Para preparar la imagen que vamos a utilizar, ejecutaremos el siguiente comando:
    doig -i mytools -t hashcat hashid seclists johntheripper
    
        Step 1/7 : FROM ubuntu:18.04
        ---> c3c304cb4f22
        ...
        ...
        Step 7/7 : COPY tools.txt .
        ---> 6d818093f1f0
        Successfully built 6d818093f1f0
        Successfully tagged mytools:latest
    
        Tools added to the image:
        [-] johntheripper: All john tools are under /opt/john/run
        [-] hashcat
        [-] hashid
        [-] seclists
    Y ahora, lo primero que necesitamos saber a la hora de crackear una contraseña, asumiendo siempre que le tengamos en forma de hash, es precisamente saber que tipo de algoritmo de generación de hash es el que tenemos entre manos.: md5, sha1, bcrypt, etcétera. 

    Identificando el tipo de Hash

    Para ello, si no sabemos qué tipo de hash tenemos, la herramienta hashid (que hemos añadido antes en nuestra imagen) es nuestra amiga. En nuestro caso vamos a crear un fichero de texto llamado samples.txt con varios hashes. Estos no tienen porque ser del mismo tipo. Vamos a utilizar hashid para que nos identifique los tipos. 

    Figura 3: Libro de Cifrado de las comunicaciones digitales:
    De la cifra clásica a RSA (2ª Edición) de 0xWord.

    Por supuesto, no podemos dejar de recomendar el libro de Cifrado de las comunicaciones digitales: de la cifra clásica a RSA (2ª Edición) que explica en detalle el cifrado y el hashing. Asumiendo que tenemos nuestro fichero samples.txt en el directorio en el que nos encontramos, podemos ejecutar nuestro contenedor montando dicho fichero dentro del mismo a modo de volumen:
    docker run -it --rm -v $(pwd)/samples.txt:/opt/samples.txt mytools
    Veamos el contenido de nuestro fichero samples.txt:
    cat samples.txt
    8743b52063cd84097a65d1633f5c74f5
    b89eaac7e61417341b710b727768294d0e6a277b
    fcf7c1b8749cf99d88e5f34271d636178fb5d130
    b4b9b02e6f09a9bd760f388b67351e2b
    127e6fbfe24a750e72930c220a8e138275656b8e5d8f48a98c3c92df2caba935
    
    Como podemos ver tenemos 5 hashes en dicho fichero. Veamos que nos dice hashid:
    hashid samples.txt
        --File 'samples.txt'--
        Analyzing '8743b52063cd84097a65d1633f5c74f5'
        [+] MD2
        [+] MD5
        [+] MD4
        ...
        ...
        [+] RAdmin v2.x
        Analyzing '127e6fbfe24a750e72930c220a8e138275656b8e5d8f48a98c3c92df2caba935'
        [+] Snefru-256
        [+] SHA-256
        [+] RIPEMD-256
        [+] Haval-256
        [+] GOST R 34.11-94
        [+] GOST CryptoPro S-Box
        [+] SHA3-256
        [+] Skein-256
        [+] Skein-512(256)
        --End of file 'samples.txt'—
    
    Con hashid, se analiza cada hash y nos da una lista de posibles algoritmos correspondientes a cada hash. hashid también nos puede proporcionar el tipo de hash en formato john the ripper o hashcat. La opción *-j* nos ofrece el format jonh:
        hashid -j samples.txt
        --File 'samples.txt'--
        Analyzing '8743b52063cd84097a65d1633f5c74f5'
        [+] MD2 [JtR Format: md2]
        [+] MD5 [JtR Format: raw-md5]
        [+] MD4 [JtR Format: raw-md4]
        ...
        ...
    Figura 4: Ejemplo de ejecución de hascat desde un contenedor
     buscando una contraseña usando fuerza bruta y utilizando GPU.
    En el vídeo al final del artículo se detalla su ejecución.

    Y la opción -m para el formato hashcat:
        hashid -m samples.txt
        --File 'samples.txt'--
        Analyzing '8743b52063cd84097a65d1633f5c74f5'
        [+] MD2
        [+] MD5 [Hashcat Mode: 0]
        [+] MD4 [Hashcat Mode: 900]
        [+] Double MD5 [Hashcat Mode: 2600]
        ...
        ...
    Hashcat

    Ahora vamos a ver un poco de información sobre hashcat. Para ver todas las opciones de esta herramienta, podemos ejecutarlo con la opción --help. Una de las opciones más importantes de hashcat son los tipos de hash, el cual podemos averiguar con el comando anteriormente visto hashid. Con la opción -m podemos especificar qué tipo de hash queremos usar. Mirando la ayuda podemos ver que la lista de modos es bastante amplia. Los modos más usados son:
          900 - MD4
            0 - MD5
         1000 - NTLM
         5500 - NetNTLMv1
         5600 - NetNTLMv2
         1100 - mscache1 (xp, w2k3)
         2100 - mscache2 (v, w7, w8, w10,w2k8+)
         3000 - LanManager
         1700 - SHA512
         7500 - Kerberos REQ
        13100 - Kerberos TGS-REP
          400 - Wordpress
         2500 - WPA
         2501 - WPA PMK
    
    Otra opción importante a tener en cuenta es el tipo de ataque:
        0 - Straight (ataques basados en lista o diccionario de palabras)
        1 - Combination (ataques basados en varias listas o diccionarios de palabras)
        3 - Brute-force (fuerza bruta o con máscara)
        6 - Hybrid Wordlist + Mask (lista de palabras + fuerza bruta/máscara)
        7 - Hybrid Mask + Wordlist (fuerza bruta/máscara + lista de palabras)
    
    Veamos un ejemplo de como crackear un hash md5 usando un diccionario:
        echo -n iloveu | md5sum
        edbd0effac3fcc98e725920a512881e0  -
    
        hashcat -m 0 -a 0 edbd0effac3fcc98e725920a512881e0
                /opt/SecLists/Passwords/Common-Credentials/10k-most-common.txt
    
    
        OpenCL API (OpenCL 1.2 LINUX) - Platform #1 [Intel(R) Corporation]
        ==================================================================
        * Device #1: Intel(R) Core(TM) i9-9880H CPU @ 2.30GHz, 15953/16017 
                                           MB (4004 MB allocatable), 8MCU
        ...
        ...
        Dictionary cache built:
        * Filename..: /opt/SecLists/Passwords/Common-Credentials/10k-most-common.txt
        * Passwords.: 10000
        * Bytes.....: 83017
        * Keyspace..: 10000
        * Runtime...: 0 secs
    
        edbd0effac3fcc98e725920a512881e0:iloveu
    
        Session..........: hashcat
        ...
        ...
    
    Como se puede apreciar, el hash edbd0effac3fcc98e725920a512881e0 ha sido encontrado:
    edbd0effac3fcc98e725920a512881e0:iloveu
    
    Con el parámetro -m especificamos el tipo de hash (0 - MD5), con -a el tipo de ataque, en este caso por diccionario, usando:

     /opt/SecLists/Passwords/Common-Credentials/10k-most-common.txt

    Es posible usar varios diccionarios, en cuyo caso usaríamos la opción -a 1:
    hashcat -a 1 -m 0 hash-to-crack diccionario1.txt diccionario2.txt ...
    
    Es posible pasar un fichero de hashes también en vez de hashes individuales. Y por supuesto se pueden hacer ataques por fuerza bruta basado en patrones con ataques del tipo 3, y mezclando la fuerza bruta con patrones usando los ataques del tipo 6 y 7. 

    Figura 5: Cracking Passwords con Docker

    Incrementando la potencia de cálculo con contenedores y GPU

    Hasta ahora, lo que hemos visto es el crackeo basado en CPU, pero realmente donde sacaremos más partido a todo este proceso será cuando usemos GPUs o FPGAs. Y esto también podemos hacerlo activando el acceso a la GPU del ordenador host por parte de los contenedores. Para poder usar la/s GPU/s dentro de contenedores Docker, tienes que instalar dentro de tu contenedor los drivers de tu GPU, y en el caso de NVIDIA tienes que instalar en tu host el paquete nvidia-docker2, como se especifica en este enlace. 


    Pero para que te sea más sencillo de utilizar en un Ethical Hacking, nosotros hemos preparado una imagen de hashcat ya con todos estos requisitos instalados (excepto nvidia-docker2, eso lo tienes que instalar en el host) que hemos llamado hashcat-nvidia y que puedes añadir en la construcción con doig como puedes ver a continuación:
    doig -u -i mytools -t seclists hashcat-nvidia hashid johntheripper
    
    Una vez creada la imagen, levantamos el contenedor. Aún estamos perfeccionando la imagen, pero todavía tenemos que pasar algunas variables de entorno desde la misma línea de comandos cuando ejecutamos el docker run:
    docker run -it --gpus all --rm -e NVIDIA_VISIBLE_DEVICES=all 
      -e LD_LIBRARY_PATH=/usr/local/nvidia/lib:/usr/local/nvidia/lib64:
      -e PATH=/usr/local/nvidia/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin
      -e  NVIDIA_DRIVER_CAPABILITIES=compute,utility mytools
    Aquí es importante introducir el comando –gpus all para que, de esta forma, podamos utilizar todas las GPUs disponibles en el host. En el siguiente vídeo podéis ver una prueba de crackeo por fuerza bruta de la misma contraseña (“iloveyou”) que utilizamos antes:


    Figura 7: Cracking password con Docker usando GPUs

    El viejo rockero, John the Ripper

    Hasta ahora hemos hablado de hashcat que es quizás actualmente la herramienta más usada para estos menesteres. Pero hablemos también de un viejo rockero: John The Ripper (JtR), protagonista sin duda de muchas de las anécdotas de la historia de la informática y los hackers.

    Figura 8: Libro de "Microhistorias: anécdotas y curiosidades
    de la historia de la informática (y los hackers)"

    Como hemos visto al inicio de esta entrada, creamos una imagen Docker en la que incluíamos JtR, así que si has seguido los pasos descritos hasta ahora debes de tener en tu contenedor dicha herramienta bajo el directorio /opt/john/run. Desde dicho directorio podemos invocar el comando john. Veamos la lista de tipos de hashes que JtR soporta:
        ./john --list=formats
    
        descrypt, bsdicrypt, md5crypt, md5crypt-long, bcrypt, scrypt, LM, AFS,
        tripcode, AndroidBackup, adxcrypt, agilekeychain, aix-ssha1, aix-ssha256,
        aix-ssha512, andOTP, ansible, argon2, as400-des, as400-ssha1, asa-md5,
        AxCrypt, AzureAD, BestCrypt, bfegg, Bitcoin, BitLocker, bitshares, Bitwarden,
        BKS, Blackberry-ES10, WoWSRP, Blockchain, chap, Clipperz, cloudkeychain,
        ...
    
    El uso de JtR es muy sencillo, al igual que hashcat podemos usar diccionarios y fuerza bruta con patrones. Así que no vamos a entrar en más detalles sobre el propio JtR. Pero sí queremos añadir que la versión de JtR que instala doig es la versión Jumbo comunitaria, la cual viene cargada con utilidades que nos permite la conversión de ficheros en formato que JtR entiende. Por ejemplo:
        # En salida tendríamos los usuarios con sus hashes listo para ser crackeados con JtR
        ./unshadow /etc/passwd /etc/shadow > salida
    
        # Para convertir ficheros ssh con clave encriptada
        python3 ssh2john.py fichero-ssh-clave-encriptada > salida
    
        # Pone en salida el hash de la contreseña de una base de datos de keepass
        ./keepass2john fichero.kdb > salida
    
    Si ejecutamos un ls -l en el directorio /opt/john/run veremos que existen muchas más herramientas de conversión.

    Restricción a los contenedores

    Si ejecutamos un ls -l en el directorio /opt/john/run veremos que existen muchas más herramientas de conversión. Para finalizar, es importante destacar que la utilización en GNU/Linux de los contenedores no hay límites en el uso de memoria o CPU (en cambio en Windows y MacOS sí que existen). Por lo tanto, es importante limitarlos para evitar llevar al colapso el host. Por ejemplo, para limitar la memoria, podrías utilizar el parámetro –memory durante la ejecución del docker run:
    docker run -it --gpus all --rm --memory="256m" mytools
    
    En este enlace encontrarás más información sobre cómo aplicar estas restricciones. De todas formas, para el caso que nos ocupa, seguramente no quieras restringir los recursos para romper las contraseñas los más rápido posible.

    Happy Hacking Hackers!!! Autores:

    Fran Ramírez, (@cyberhadesblog) es investigador de seguridad y miembro del equipo de Ideas Locas en CDO en Telefónica, co-autor del libro "Microhistorias: Anécdotas y Curiosidades de la historia de la informática (y los hackers)", del libro "Docker: SecDevOps", también de "Machine Learning aplicado a la Ciberseguridad” además del blog CyberHades. Puedes contactar con Fran Ramirez en MyPublicInbox.


     Contactar con Fran Ramírez en MyPublicInbox

    Rafael Troncoso
    (@tuxotron) es Senior Software Engineer en SAP Concur, co-autor del libro "Microhistorias: Anécdotas y Curiosidades de la historia de la informática (y los hackers)", del libro "Docker: SecDevOps" además del blog CyberHades. Puedes contactar con Rafael Troncoso en MyPublicInbox.


    Contactar con Rafael Troncoso en MyPublicInbox

    Entrada destacada

    Hacking IA: Jailbreak, Prompt Injection, Hallucinations & Unalignment. Nuestro nuevo libro en 0xWord

    Pocas veces me ha hecho tanta ilusión que saliera un nuevo libro en 0xWord como con este libro de " Hacking IA: Jailbreak, Prompt Inje...

    Entradas populares