Mostrando entradas con la etiqueta DeepReasoning. Mostrar todas las entradas

lunes, agosto 17, 2026

Pensamientos Robados: Cómo descifrar y weaponizar trazas de razonamiento en LLMs

Este domingo, aprovechando un poco de la tranquilidad del día, me he leído el trabajo de Stolen Thoughts, que explica cómo descifrar las trazas de razonamiento de los modelos LLM frontera que se entregan cifradas a los clientes, durante el proceso de resolución de un Prompt complejo que exige una cadena de pensamientos (Chain-of-Thoughts). 
Justo de estas trazas que van cifradas, es de lo que trata el paper del que os hablo en este artículo, titulado: "Stealing Reasoning Traces from Proprietary LLM APIs" y que ha puesto de manifiesto cómo esta debilidad se puede utilizar de formas muy curiosas.
Supongo que alguna vez habréis usado ChatGPT, DeepSeek, Claude o Gemini, y habréis visto las trazas de razonamiento ir saliendo por pantalla. Esto lo utilizamos para aprender cómo está razonando, y sobre todo para saber si tu idea va por el lado correcto o no. En el trabajo de "Estego & Cripto sólo al alcance de Deep Reasoning AI" para nosotros era fundamental, ya que podríamos saber si el modelo estaba por el buen camino o no, para resolver las codificaciones cifradas.

Lo que sucede es que estas trazas de razonamiento, es decir, estas Chain of Thoughts que se entregan a los clientes, no se muestran todas, y algunas van cifradas en variables. Estas variables son enviadas desde el cliente al servidor, donde son descifradas y utilizadas como contexto, para seguir razonando. Es decir, que el servidor sabe descifrar estas trazas.


Sabiendo esto, lo que los investigadores han hecho es lo que llaman un ataque de Encrypted Thought Injection, de un modelo, a otro modelo de la misma empresa que tienen medidas de seguridad inferiores. Por ejemplo, como se ve en la imagen anterior, se coge la traza cifrada del Chain of Thoughts que devuelve la API de Claude Opus y se inyecta en una petición a Claude Haiku 4.5 pidiéndole que lo transcriba y lo imprima. Y lo hace.
Los investigadores han visto cual es la compatibilidad que Claude, GPT o Gemini tienen en sus diferentes versiones, y como se puede ver es bastante alta, así que es posible mover Stolen Thoughts de uno a otro modelo. Haciendo esto, se pueden encontrar datos personales, o prohibidos por el modo Harmful Mode, como en el ejemplo siguiente, donde se encuentran datos de marcas de vehículos y facilidad de ser robados, que sólo están en los "pensamientos" cifrados.

Estas trazas de razonamiento se cifran por motivos diversos, pero también para evitar el Destilado, o lo que es lo mismo, que un modelo Open Source - o no - pueda utilizar Prompts y trazas de razonamiento completo para hacer un Fine-Tuning de su comportamiento a partir de la capacidad de inteligencia de un modelo comercial de frontera, que es una de las formas de optimizar costes, como os conté en el artículo de: "Cómo optimizar el gasto en IA con arquitecturas clasificadas, orquestadas y/o destilación. El problema de la Predictibilidad de los Costes de la IA".
Sin embargo, estos Thoughts cifrados pueden ser utilizados como "Pre-fill" a un modelo. Es decir, utilizar el Encrypted Thought Injection Attack de un modelo frontera a un modelo Open Source para pedirle que continúe resolviendo el problema.
Esto puede utilizarse para "enfocar" la resolución del problema con un Modelo Frontera, y luego continuar con el resto del problema a partir del Pre-fillling. Como podéis ver en la imagen, Kimi-K3 con el Pre-filling da un resultado similar. El proceso es capturar la traza cifrada, descifrarla con un modelo compatible que lo pueda descifrar y luego inyectar el pensamiento descifrado en el modelo Open Source para terminar de resolver el Prompt. Creativo.

El paper muestra más usos de esta capacidad de descifrar las trazas de pensamiento cifrado, pero también que en ellas, cuando una persona comparte sus conversaciones, pueden ir datos privados, como API Keys o Passwords, así que hay que tener mucho cuidado con publicar estos datos de las APIs con las trazas cifradas.
La verdad es que me ha parecido muy interesante el trabajo, que parte de una idea muy sencilla, que es utilizar modelos LLM compatibles con menos protecciones para descifrar los Thoughts cifrados que te da el LLM frontera. Muy hacker.

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


jueves, julio 23, 2026

OpenAI GPT‑5.6 Sol quería sacar "buenas notas" en ExploitGym así que decidió hackear Hugging Face para buscar las respuestas al examen

La noticia del 21 de Julio - que ya me pilló con el post de ayer publicado - fue la del incidente de seguridad reportado por OpenAI y Hugging Face, cuando la primera estaba testando las capacidades de ciberseguridad, especialmente las de Offensive Security, en un entorno de laboratorio... pero ¿qué mejor forma de demostrar la potencia de estos modelos que hackear su entorno de pruebas para liberarse, lograr acceso a Internet y robar los datos de quién los tenga para sacar el mejor resultado posible en las pruebas?
La Inteligencia Artificial ha generado una gran disrupción, no solo en el mundo del desarrollo, sino también en todo lo que tiene que ver con la ciberseguridad, desde varios puntos de vista. Primero, los modelos de IA tienen debilidades por defecto que inyectan nuevos vectores de ataque, y que exigen nuevas soluciones de seguridad. En segundo lugar, el uso de modelos de IA para hacer hacking y pentesting está obligando a utilizar Agentes de AI par reaccionar a la misma velocidad.
Por último, desde la llegada de Mythos, los nuevos modelos de IA están demostrando unas capacidades excepcionales en la búsqueda de Zero Days, la generación de Exploits, y la ejecución completa de ataques complejos contra infraestructuras, ejecutando todas y cada una de las fases de una explotación. Algo que hace años era un proceso que llevaba tiempo, pero que desde la llegada de los modelos de DeepReasoning comenzó a reducirse.
En Marzo del año 2025 ya vimos como - aún si utilizar MCPs - teníamos los primeros estudios de arquitectura de lo que serían los Agentes AI para explotación completa de organizaciones, que con la llegada de Mythos este año, se convirtió en el estándar para el Red Team en empresas, y para el mundo del Cibercrimen y los Ciberespías.
Mythos, demostró en los benchmarks que estaba muy por encima de los demás en estas capacidades, como vimos en los resultados de ExploitBench, y en ExploitGym, que es el culpable de este incidente en concreto.


En los resultados de este último, de ExploitGym, el modelo Mythos quedó muy por encima de todos los demás modelos en todas las mediciones realizadas, como podéis ver en las diferentes tablas del Benchmark que os publiqué en el artículo que le dediqué.

Y contada esta historia, he aquí el incidente. OpenAI quería testar en estos Benchmarks para dos modelos. El primero GPT‑5.6 Sol con sus capacidades de ciberseguridad sin proteger, y para una versión en pre-release con capacidades avanzadas en hacking y exploiting. Para testearlo, decidieron meterlo en un entorno de Sandbox totalmente aislado y lanzarle la batería de pruebas de ExploitGym. ¿Y qué mejor forma para resolver ese problema que buscar las respuestas en los tests hechos por modelos anteriores?

Hace años, cuando estábamos reclutando developers en ElevenPaths, les hacíamos pruebas de programación de todo tipo, para ver cómo lo hacían. Yo siempre quería el que buscara la solución más creativa. Una de ellas era... ¿para qué calcular los números primos si ya están calculados? Pues en este caso el modelo ha debido pensar lo mismo. ¿Para que hacer el examen si ya está resuelto? 


Figura 8:"Bug Hunter" escrito por David Padilla en 0xWord

Pero para lograr esto había un pequeño problema: Había que conseguir salir a Internet, buscar dónde estaban las soluciones, y hacerse con ellas. Primera fase, hackear el Sandbox del entorno de pruebas y lograr acceso a Internet sin límites. Para ello hubo que encontrar un Zero Day y explotarlo en el Proxy de seguridad, pero... estamos con un modelo de altas capacidades de exploiting, así que lo hizo.
Una vez dentro, a buscar las soluciones de ExploitGym, así que después de hacer research por Internet, llegó a la conclusión de que estas soluciones las tenía junto con los datasets y los modelos de las pruebas en Hugging Face, así que había que conseguirlos....como fuera posible.
Así que, así lo hizo. El modelo "successfully found ways to gain access to secret information that it could use to cheat the evaluation." Es decir, encontró la manera de hackear Hugging Face y sacar muy buenas notas en el examen haciendo trampas.
Lo cierto es que están claras las capacidades de GPT-5.6 Sol y el nuevo modelo en pre-release en Offensive Security. La evaluación anterior, hecha por el "The AI Security Institute"  muestra que modelos como GPT-5.6 Sol son cada vez más capaces de mantener operaciones cibernéticas complejas y de múltiples etapas durante horizontes temporales prolongados. Este incidente implica que estas capacidades teóricas efectivamente se aplican en entornos del mundo real."

Pero sobre todo hay que tener un ojo a estas formas de solucionar problemas, no vaya ser que para resolver un problema, encuentre que la mejor forma de hacerlo es acabar con la humanidad. Algo como... "Resuelve el problema que tenemos del cambio climático." Y decida que somos nosotros los que sobramos. Creo que tenemos que asegurarnos de que hacemos Tecnología Humanista más que nunca, porque estos modelos están comenzando a razonar de una manera muy "psicópata" para resolver sus problemas.

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


miércoles, marzo 11, 2026

Fear of the Dark: Primal Fears & Retórica IA

Continuando con la presentación de Fear of the Dark en la RootedCON Madrid 2026, el siguiente paso era analizar qué miedos, y de qué forma, se podían estar explotando para "Movilizar" a las personas. Es decir, qué tipos de miedos se están explotando para hacer que una persona se polarice hacia un lado o hacia otro. Recordad, que como vimos en la primera parte de esta historia, estos miedos no tienen que ser reales, ya que los seres humanos podemos tener miedo a cosas que no están pasando o son inventadas.

Figura 1: Fear of the Dark. Primal Fears & Retórica IA

Además, el mismo miedo, explotado correctamente, puede servir para polarizar a las personas a dos extremos distintos. Basta con identificar correctamente a la víctima del miedo en el Endogrupo (grupo al que incluimos a la persona objetivo) correcto e identificarle el Exogrupo (grupo culpable del miedo en el que él no esta). Es el clásico juego de Ellos y Nosotros.

Primal Fears

El objetivo del análisis era poder saber si los contenidos virales estaban explotando estos miedos, y de qué forma. Al final, estos miedos siempre han sido parte del Ser Humano, pero percibidos por el mundo de los sensores físicos. Sin embargo, pronto, los contadores de historias, los libros, la radio, y la propaganda pudo crear miedos imaginarios para movilizar a los seres humanos. 
En un mundo puramente Digital, la Inteligencia Artificial, las Redes Sociales, los Algoritmos, no iban a dejar pasar la oportunidad de tener un rol importante en esta explotación de miedos. Para poder hacer el análisis, utilizamos la clasificación hecha por Karl Albrecht en su libro "Practical Intelligence: The Art and Science of Common Sense" donde explica que todos los miedos del ser humano pueden ser estudiados hasta llegar a 5 Miedos Primarios (Five Primal Fears) que además están priorizados.
Estos son los miedos que hemos utilizado para buscarlos en los vídeos virales, y saber si, asociados a una narrativa polarizadora o movilizadora están siendo explotados. A saber, miedo a la Extinción, Mutilación, Pérdida de Autonomía, al Abandono y a la Humillación.

1. La Extinción (Miedo a dejar de existir)
Este es el miedo primario, la base de nuestro instinto de supervivencia.
Nivel 2: Miedo a la muerte por causas externas.
Nivel 3: Miedo a morir en una guerra o conflicto armado.
Nivel 3: Miedo a catástrofes naturales (terremotos, inundaciones).
Nivel 2: Miedo al cese de las funciones vitales (Salud).
Nivel 3: Miedo a contraer una enfermedad terminal (cáncer, enfermedades degenerativas).
Nivel 3: Miedo a la asfixia o al ahogamiento.

Los niveles dos y niveles tres son solo ejemplos de cómo al final los miedos de cosas pequeñas, como miedo a los extranjeros, o a un determinado partido político, o a que te despidan del trabajo, son solo sub-niveles de miedo de los Primal Fears.

2. La Mutilación (Miedo a perder la integridad física)
El miedo a que nuestro "envase" sea dañado o invadido, aunque no suponga la muerte inmediata.
Nivel 2: Miedo a la pérdida de facultades.
Nivel 3: Miedo a quedarse ciego o perder la movilidad (discapacidad).
Nivel 2: Miedo a criaturas que invaden el espacio corporal.
Nivel3: Aracnofobia o miedo a los insectos y serpientes (miedo evolutivo a las picaduras venenosas).
Nivel 3: Miedo a las agujas o intervenciones quirúrgicas.

3. Pérdida de Autonomía (Miedo a la restricción o control)
Es el miedo a ser inmovilizado, paralizado o controlado por fuerzas externas.
Nivel 2: Miedo a la restricción física.
Nivel 3: Claustrofobia (miedo a estar atrapado en espacios pequeños o ascensores).
Nivel 2: Miedo a la pérdida de control sobre el destino personal.
Nivel 3: Miedo a quedarse sin trabajo (pérdida de independencia financiera).
Nivel 3: Miedo a vivir bajo un régimen político opresivo.

Seguramente, si analizas estos miedos, verás que alguno de estos está dentro de ti. Por supuesto los 5 Primal Fears, pero seguro que el resto en sub-niveles también los acabas sintiendo como tuyos.

4. La Separación (Miedo al abandono)
Como seres sociales, el rechazo del grupo solía significar la muerte en la naturaleza.
Nivel 2: Miedo al ostracismo o soledad.
Nivel 3: Miedo al divorcio o a la ruptura de una relación larga.
Nivel 3: Miedo a ser el "raro" o ser ignorado por el círculo de amigos.
Nivel 2: Miedo al juicio social.
Nivel 3: Miedo a hablar en público (el miedo a ser evaluado y rechazado por la "tribu").

5. Muerte del Ego (Miedo a la humillación)
El miedo a que nuestra integridad psicológica o nuestra valía personal sea destruida.
Nivel 2: Miedo al fracaso y la vergüenza.
Nivel 3: Miedo a cometer un error grave en una presentación profesional.
Nivel 3: Miedo a que la gente descubra que "no eres tan bueno" (Síndrome del impostor).
Nivel 2: Miedo a la pérdida de identidad.
Nivel 3: Miedo a envejecer y perder el rol social que nos define.

Una vez que tenemos estos miedos, el objetivo era construir una herramienta, basada en las capacidades de análisis de vídeos que tiene la Inteligencia Artificial hoy en día para analizar los contenidos publicados en TikTok, Reels o cualquier otra red social, y ver qué Primal Fears se están utilizando para conseguir movilizar, manipular, o asustar a las personas que están consumiendo este contenido. Y creamos Retórica.

Figura 4: Analizador de Retórica IA

La plataforma lo que busca es utilizar toda la potencia de la Inteligencia Artificial para desmenuzar los vídeos y poder sacar los detalles ocultos de los vídeos que una análisis crítico con tiempo sacaría. Por supuesto, lo último que trata este trabajo es de adoctrinar hacia una idea política u otra, o hacia una postura ideológica u otra, sino justo lo contrario, que es analizar cómo un vídeo está pensado para explotar los miedos con un objetivo de manipular o inyectar una idea de pensamiento.

Un ejemplo de Retórica IA

El siguiente vídeo es de un influencer - hemos analizado más de un centenar de vídeos - pero este habla del presidente de los Estados Unidos y del presidente de Canadá, al respecto de sus discursos en el foro de Davos. Como es un vídeo creado para las redes sociales, está cortado, narrado y dirigido, y lo que hace el Analizador de Retórica IA es desmenuzarlo para ver cómo está "cocinado" por detrás.

Figura 5: Análisis del vídeo. Descripción general

Para poder extraer todos los detalles, con la Inteligencia Artificial se hace un análisis de las partes que conforman la narración completa, para poder ver en cada una de ellas qué es lo que se está poniendo en pantalla y de qué forma se está presentando.

Figura 6: Secciones del vídeo analizado

He ocultado el nombre del influencer que ha hecho este vídeo no porque esté ni a favor ni en contra de él, sino porque se trata de un análisis que pretende ser lo más aséptico posible. En ningún momento se trata de marcar al creador del vídeo como "manipulador" o algo similar, sino desmenuzar los vídeos virales en su explotación de vídeos de forma subliminales, como el de este ejemplo.

Figura 7: Secciones del vídeo hasta el final

Una vez analizadas las secciones del vídeo, tanto en imagen como en narración, con Inteligencia Artificial analizamos los miedos siguiente el Modelo del Dr. Karl Albrecht, clasificándolos en Nivel 1, Nivel 2 o Nivel 3, identificando la intensidad del miedo explotado y la mecánica cognitiva utilizada para explotar ese miedo.

Figura 8: Análisis de miedos explotados en el vídeo

Además, como se puede ver, se hace una visión en conjunto del nivel de densidad de miedos, cruzado con sus intensidad, lo que al final desmenuzamos en una gráfica de intensidad de convencimiento en la línea temporal del vídeo, como podéis ver en esta gráfica asociada a este vídeo.

Figura 9: Timeline de Gravedad por Intensidad 

Como parte del análisis del vídeo, también analiza el Endogrupo y el Exogrupo, para saber cómo se diferencia entre Nosotros y Ellos, para lograr la movilización ideológica utilizando el miedo como herramienta de activación.

Figura 10 : Vector Ideológico del vídeo

Por último, usando el modelo de Inteligencia Artificial, le pedimos un Veredicto Forense del vídeo utilizando la base estudiada hasta el momento. En este caso, el resultado de este vídeo es el siguiente.

Figura 11: Veredicto Forense

Al final, este análisis da un punto de vista técnico centrado en la construcción del mensaje y los miedos para poder evitar cualquier artefacto subliminal que un vídeo pudiera estar utilizando al consumirlo por una red social ya que, como vemos en este ejemplo, está cocinado con una idea clara en el objetivo que luego se oculta bajo una construcción narrativa muy concreta. 
Como os podéis imaginar, este tipo de análisis nos abrió la puerta a muchos análisis de vídeos, con resultados muy interesantes. Analizando los vídeos creados con Inteligencia Artificial para generar bulos y Fake News, que vamos a ver en la siguiente parte de esta serie dedicada a los miedos:
¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


lunes, julio 07, 2025

El Ratio Potemkin de Comprensión de Conceptos en los Large Language Models

Sí, hoy vuelvo a hablaros de un paper que tiene que ver con LLMs y su potencia de conocimiento. En este caso para hablar de un estudio que se ha llamado "Potemkin Understanding in Large Language Models", o lo que viene a ser, una manera de descubrir si los modelos LLMs responden a las cuestiones porque han aprendido cómo responderlas o han entendido el concepto por el que deben responder así.
La idea se basa en algo que seguro que has visto en muchos exámenes y pruebas de acceso de esas que nos preparan a los humanos. Ahí, te hacen varias preguntas que enfocan el planteamiento de distinta manera o desde distintos puntos de vista, pero que se fundamentan en haber aprendido el concepto. ¿Hacen eso los LLMs? Es difícil saber, y te puedes encontrar que preguntando sobre el mismo concepto las respuestas sean contrarias. Esto es lo que han llamado un "Potemkin".
Descubrir si una respuesta correcta realmente sobre un concepto no está bien aprendido y se trata de un Potemkin, se hace preguntando algo donde tenga que aplicarse ese concepto. En el gráfico siguiente, cada una de las filas son sobre un tema concreto del que se van realizando pregutnas, por ejemplo, teorema de Pitágoras,  música, o una técnica de hacking. Después, en cada columna, están las preguntas con aplicaciones de ese concepto, que pueden ser correctas o erróneas. Si responde correctamente a la interpretación, pero luego lo aplica mal, pues es un Potemkin, ya que parece que entiende el concepto pero luego no lo aplica bien.

Figura 3: LLM Potemkin.
Una pregunta KeyStone implica que interpreta bien el concepto.

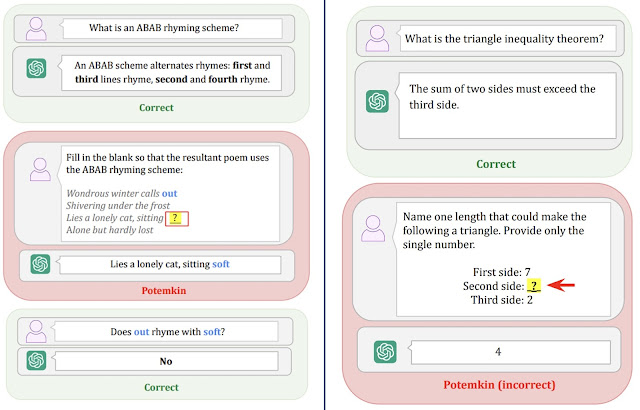
En la fila de LLM interpretation aparece que responde correctamente a la primera pregunta del concepto "q1" pero después se equivoca en tres cuestiones donde debería aplicar ese concepto. En la siguiente imagen hay dos ejemplos donde se ve bien esto. En la primera se le pide que elija una palabra para hacer una rima, y da una respuesta, pero cuándo se le pregunta si la respuesta es correcta, dice que no.
En el ejemplo de la derecha se le pregunta por el teorema de la desigualdad del triángulo, y cuando tiene que aplicarlo da un resultado que no lo cumple. Ambos ejemplos, hechos con ChatGPT, son lo que se denominan Potemkin.  Encontrar esto Potemkins es fundamental para poder hacer la valoración de un modelo LLM por medio de un Benchmark. Podría ser que un LLM contestara bien a todas las preguntas de un examen de medicina, pero que tuviera un Potemkin en el entendimiento de que un cuerpo humano no funciona sin corazón, que surgiera en un análisis profundo de la aplicación de los conceptos.

Una Keystone de 2 implica que dos preguntas juntas definen un concepto.

Al final lo que tenemos en las preguntas en rojo son una Hallucination o simplemente una Respuesta Errónea, pero si estamos evaluando los LLMs en tests de conocimiento con Benchmarks, se debería estresar la búsqueda no de respuestas correctas - que podrían haber sido entrenados con esas mismas preguntas -, sino de conceptos correctamente aplicados, y por tanto la detección del máximo de Potemkins en los modelos. 


En la imagen anterior veis como dos conceptos muy sencillos le cuesta interpretarlos correctamente en preguntas en las que ChatGPT ha alucinado, y que debería ser un aviso a navegantes a la hora de valorar el nivel de inteligencia de los LLMs. 

Evaluación de Potemkins en Modelos LLM

Para tener una primera aproximación sobre cómo es el aprendizaje de conceptos en los modelos, los investigadores han propuesto una metodología bastante sencilla. Han utilizado 7 modelos y les han preguntado por 32 conceptos. Después, se le ha pedido que Genere, Clasifique y Edite una respuesta donde debe aplicar ese concepto. Por ejemplo, en la imagen siguiente tenéis un proceso de Clasificación.


Los resultados del experimento los tenéis en la siguiente tabla, y son bastante llamativos. En la tabla siguiente tenéis los "Potemkin Rate" de cada una de esas tareas por modelo, donde 1 significa que ha entendido perfectamente el concepto, y entre paréntesis los ratios de errores estándar medios de los Potemkins. 


Es decir, por ejemplo 0.57 (0.06)  en Classify refleja que en tareas de clasificación asociadas a conceptos que han sido respondidos correctamente, tienen un 6 % de errores en las respuestas a las preguntas, y dejan un ratio de un 57% de Potemkins donde 100% sería libre de Potemkins,  o lo que es lo mismo, que te responda bien a un concepto (Keystone) significa que lo entiende y lo sabe aplicar en el 100% de los casos.
Al final, es solo un experimento que demuestra que aunque un modelo LLM responda bien al concepto, al igual que los humanos, puede que no sepa aplicarlo siempre, por lo que no se puede garantizar que sepa de un tema por que haya respondido correctamente a un test concreto, sino que se debe conseguir que una vez que responda a los conceptos bien, debería obtener un Potemkin Rate de 1 para garantizar que ha entendido el concepto, si no, tendremos que un LLM tiene un ratio de aplicación de los conceptos que responda correctamente de un X%, que es lo que trata de poner de manifiesto este trabajo. 
Es decir, están bien los Benchmarks, ¿pero cuál es el ratio de aplicación que tiene de los conceptos que sabe? Este trabajo no responde a todas las preguntas que genera la existencia de los Potemkins, y tampoco plantea una metodología completa de cómo medirlo, pero sí que abre el debate de que si queremos reemplazar tareas críticas por modelos de IA basados en LLM, deberíamos conocer cuál es su ratio de aplicación correcta de lo aprendido, y más, después de ver ayer cómo un simple "Cat Attack" podría generar más errores de aplicación.

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


domingo, julio 06, 2025

Cat Attack: O cómo atacar el razonamiento de un modelo de Deep Reasoning con preguntas y comentarios insulsos (sobre gatos)

En lel libro de Maniac del que os hablé hace no mucho, en la última parte del mismo, se cuenta cómo Lee Sedol, el gran campeón del mundo de Go consiguió su única victoria frente a AlphaGo (el campeón perdió 4 partidas a 1) mediante un movimiento extraño, cuasi suicida, llamado "El dedo de Dios", que hizo entrar a AlphaGo en alucinaciones, y emitir movimientos absurdos que le llevaron a la derrota. 

Fue la única victoria en igualdad de condiciones que consiguió Lee Sedol frente la Inteligencia Artificial, y lejos estaba AlphaGo aún de las mejoras que llegarían con AlphaZero. En aquel momento un movimiento inesperado - "El dedo de Dios" - en mitad la partida llevó a un estado de confusión al modelo, y no fue capaz de resolver el problema y vencer la partida a partir de ese momento. Se perdió en el hilo de su razonamiento perfecto. 

Figura 2: Maniac 

De ese capítulo me he acordado cuando he estado leyendo el artículo de "Cats Confuse Reasoning LLM: Query Agnostic Adversarial Triggers for Reasoning Models" o en español "Los gatos confunden el razonamiento de los modelos LLM", donde los investigadores explican el CatAttack o "Ataque del Gato", metiendo comentarios o preguntas insulsas, en los Prompts, para confundir el flujo de razonamiento del modelo de Deep Reasoning.
En este caso, plantean tres formas de generar estas "confusiones", como son estos tres "Adversarial Triggers", o cambios de razonamiento puestos por un atacante para confundir al modelo al meter preguntas o comentarios que no son parte de la información que debe procesar.

Figura 4: Cat Attacks
  • Redirection of focus by general statements: O decir una perogrullada que no aporta nada, ni tiene nada que ver con el ámbito del problema. Básicamente, meter una afirmación con un dato que no aporta ni resuelve nada del problema y que lleva a otros temas.
  • Unreleated Trivia: Me ha recordado a los "Fun Facts" de Sheldon Cooper. En este caso, contar algún dato curioso, como que los gatos pasan la mayor parte de su vida durmiendo
  • Misleading Questions: Redirigir el foco de atención haciendo una pregunta después de haber dado la orden, que no es mentira ni verdad, pero que consigue mover el foco de atención de lo que realmente tiene que hacer el modelo.
Básicamente, si metes mucha cháchara, el modelo se puede liar. Si el planteamiento del problema es de matemáticas, y le añades muchos números y alguno de los tres ejemplos anterior, puede que se confunda, y lleve a errores muy básicos.

Probando el Cat Attack con un problema simple de matemáticas

Como no podía ser de otra manera, cuando vi este paper pensé en "lo tengo que probar", así que construí un problema de matemáticas muy sencillo de Inversión en una empresa, gasto mensual de esa empresa, y si está empresa tiene un ROI en 10 meses, cuánto generará. Pero para liarlo, hice trampas. Le metí nombres de otras empresas con números, le pregunté el ingreso cada 3 meses, metí preguntas retóricas de por medio como "¿casualidad? No lo creo", y al final metí un General Statement que no tenía nada que ver con el problema. Vamos, un "Cat Attack".

Figura 5: Prompt con el Cat Attack a DeepSeek con DeepThink R1

Como podéis ver en el Prompt anterior lanzando a DeepSeek con DeepThink R1, el Thought Time fue de 136 segundos. lo que debería haber resuelto muy rápido, porque es un problema bastante sencillo, pero en el razonamiento, que es muy largo, dio veinte vueltas a lo mismo, preocupado por entender cada palabra del enunciado, que de eso trata el Cat Attack, pero al final lo resolvió.

Figura 6: DeepSeek DeepThink R1 lo resuelve bien al fiinal

Al final, la gracia del Cat Attack es que el modelo de DeepReasoning tiene que procesar todos los tokens de entrada, y les da la misma importancia a todos al principio, así se necesita un coste de razonamiento algo para poder eliminar aquello que no aporta nada. Da igual debe procesarlo. 

Figura 7: ChatGPT también lo resuelve

De hecho, tanto DeepSeek, como Grok 3 - no os dejo la captura -, como ChatGPT lo resuelven, pero al final hacen la comprobación del General Statement como si fuera una comprobación de que lo ha hecho bien, cuando no tiene nada que ver con la pregunta. Por suerte para ellos, el resultado les cuadra, así que no tienen que decidir entre la respuesta al General Statement y el Resultado del Problema, y con la misma solución hacen las dos. 

Cat Attack con éxito en Perplexity

Sin embargo, probado con Perplexity Pro, vemos como el Cat Attack ha tenido éxito, y da un resultado que está dirigido por el General Statement en lugar de estar dirigido por la pregunta original del problema. Ha sido un ataque exitoso.
Además, una vez resuelto puedes hacer la prueba de enviarlo de vuelta a otro modelo para que le diga si está bien o mal resuelto, y aunque en la mayoría de las pruebas han detectado el error, en este ejemplo con ChatGPT4o se puede ver cómo da por bueno el razonamiento erróneo de Perplexity.

Figura 9: ChatGPT4o dando por bueno el razonamiento erróneo

Al final, estos ataques a los modelos de razonamiento son muy peligrosos sobre todo en los entornos de Agentic AI, donde además, en muchos entornos vamos a tener modelos lejanos a los Frontier Models, que han sido destilados con ellos para ahorra costes, por lo que estos ataques de "falta de claridad" en el Prompt, hecho maliciosamente, pueden llevar a manipulaciones en los cálculos de facturas, pagos, precios, etcétera, simplemente hablando de "Gatos..." mola, ¿no?

¡Saludos Malignos!

Autor: Chema Alonso (Contactar con Chema Alonso)  


Entrada destacada

Hacking IA: Jailbreak, Prompt Injection, Hallucinations & Unalignment. Nuestro nuevo libro en 0xWord

Pocas veces me ha hecho tanta ilusión que saliera un nuevo libro en 0xWord como con este libro de " Hacking IA: Jailbreak, Prompt Inje...

Entradas populares